
AI 学习资料 · 生成式 AI 入门(精选 7 课)
检索增强生成(RAG)和向量数据库
编者注:本课是原课程的第 15 课。原课中的代码示例,本库都改为一句话说明,完整代码请看原课程第 15 课。
在原课程讲搜索应用的那一课(第 8 课,本库未收录)中,我们简单了解了如何把你自己的数据整合进大语言模型(LLM)。本课将进一步深入:如何在 LLM 应用中让模型以你的数据为依据(grounding),这个过程的工作机制,以及存储数据(包括嵌入和文本)的方法。
简介
本课将涵盖以下内容:
-
RAG 简介:它是什么,为什么要在人工智能(AI)中使用它。
-
了解什么是向量数据库,并为我们的应用创建一个。
-
一个把 RAG 整合进应用的实际例子。
学习目标
完成本课后,你将能够:
-
解释 RAG 在数据检索和处理中的意义。
-
搭建 RAG 应用,让 LLM 以你的数据为依据作答。
-
在 LLM 应用中有效地整合 RAG 和向量数据库。
我们的场景:用自己的数据增强 LLM
在本课中,我们想把自己的笔记加入这家教育初创企业的产品,让聊天机器人能获取各个科目的更多信息。借助这些笔记,学习者能学得更好、更好地理解各个主题,复习备考也更轻松。为了搭建这个场景,我们将使用:
-
Azure OpenAI:用来构建聊天机器人的 LLM -
Microsoft《AI for Beginners》课程中关于神经网络的一课:作为 LLM 回答时依据的数据
-
Azure AI Search和Azure Cosmos DB:作为向量数据库,用来存储数据和创建搜索索引
用户将能根据笔记生成练习测验和复习卡片,并把笔记总结成简明的概要。首先,我们来看看什么是 RAG,以及它是怎样工作的。
检索增强生成(RAG)
由 LLM 驱动的聊天机器人会处理用户的提示词,生成回答。它是交互式的,能和用户就各种各样的话题交流。但它的回答局限于所提供的上下文和它的基础训练数据。例如,GPT-4 的知识截止于 2021 年 9 月,也就是说,它不知道这之后发生的事。此外,用来训练 LLM 的数据并不包含机密信息,比如个人笔记或公司的产品手册。
编者注:上面说的是 GPT-4 早期版本的情况,较新模型的知识截止时间更晚,但“不知道截止日期之后的事”这一局限依然存在。
RAG(检索增强生成)的工作原理
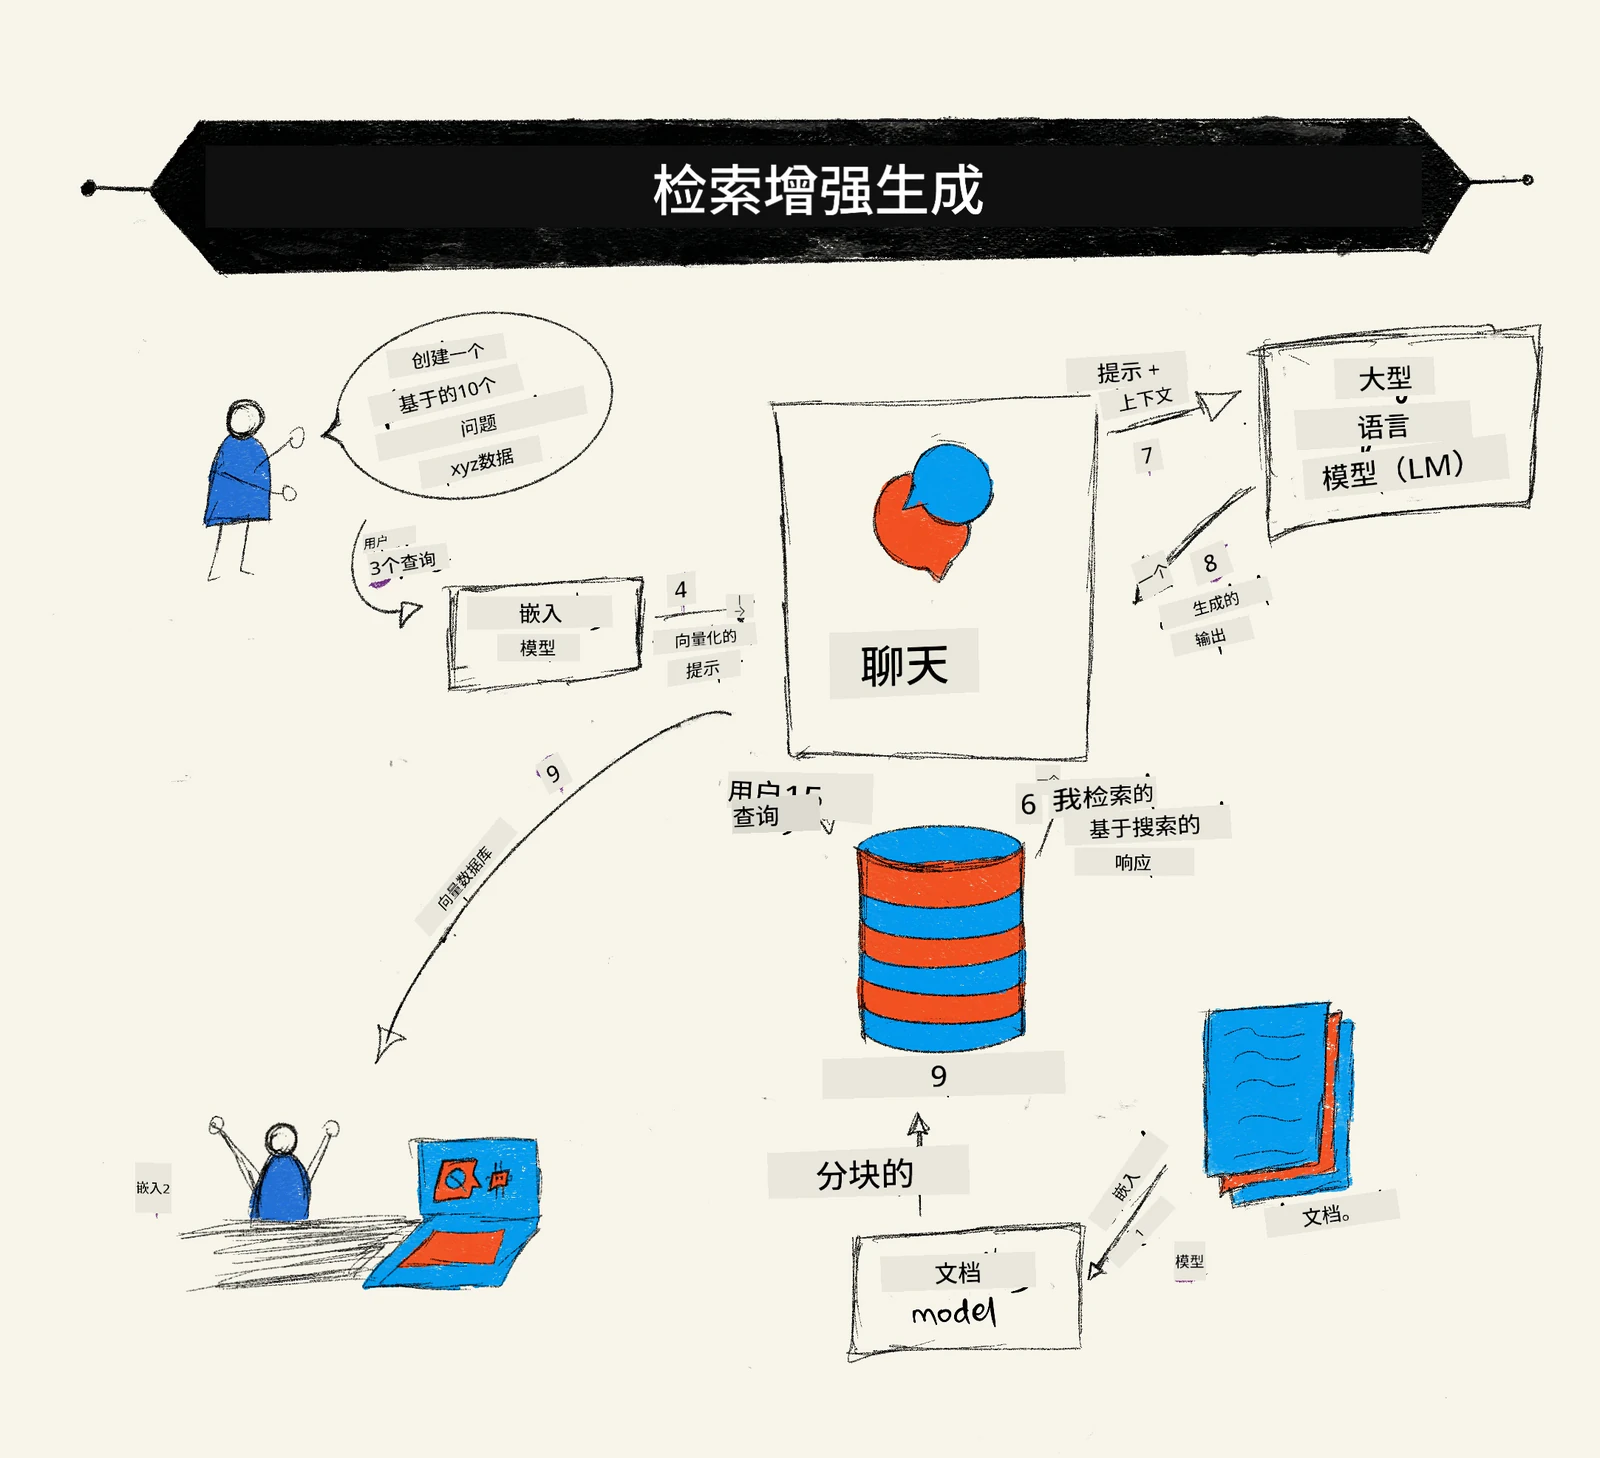
编者注:此图中文由机器翻译生成,部分标注残缺或错位(例如“用户15查询”“嵌入2”),流程请以下面的文字说明为准。
假设你想部署一个能根据你的笔记出测验题的聊天机器人,就需要把它和知识库连接起来。这正是 RAG 派上用场的地方。RAG 的工作方式如下:
-
知识库: 在检索之前,需要先导入并预处理这些文档,通常是把大文档拆分成较小的块(chunk),把它们转换成文本嵌入,再存进数据库。
-
用户查询: 用户提出问题。
-
检索: 用户提问时,嵌入模型会从我们的知识库中检索出相关信息,提供更多上下文,并把它们并入提示词。
-
增强生成: LLM 根据检索到的数据来增强它的回答。这样生成的回答不仅基于预训练数据,还用上了新增上下文中的相关信息。检索到的数据用来增强 LLM 的回答,随后 LLM 把答案返回给用户。
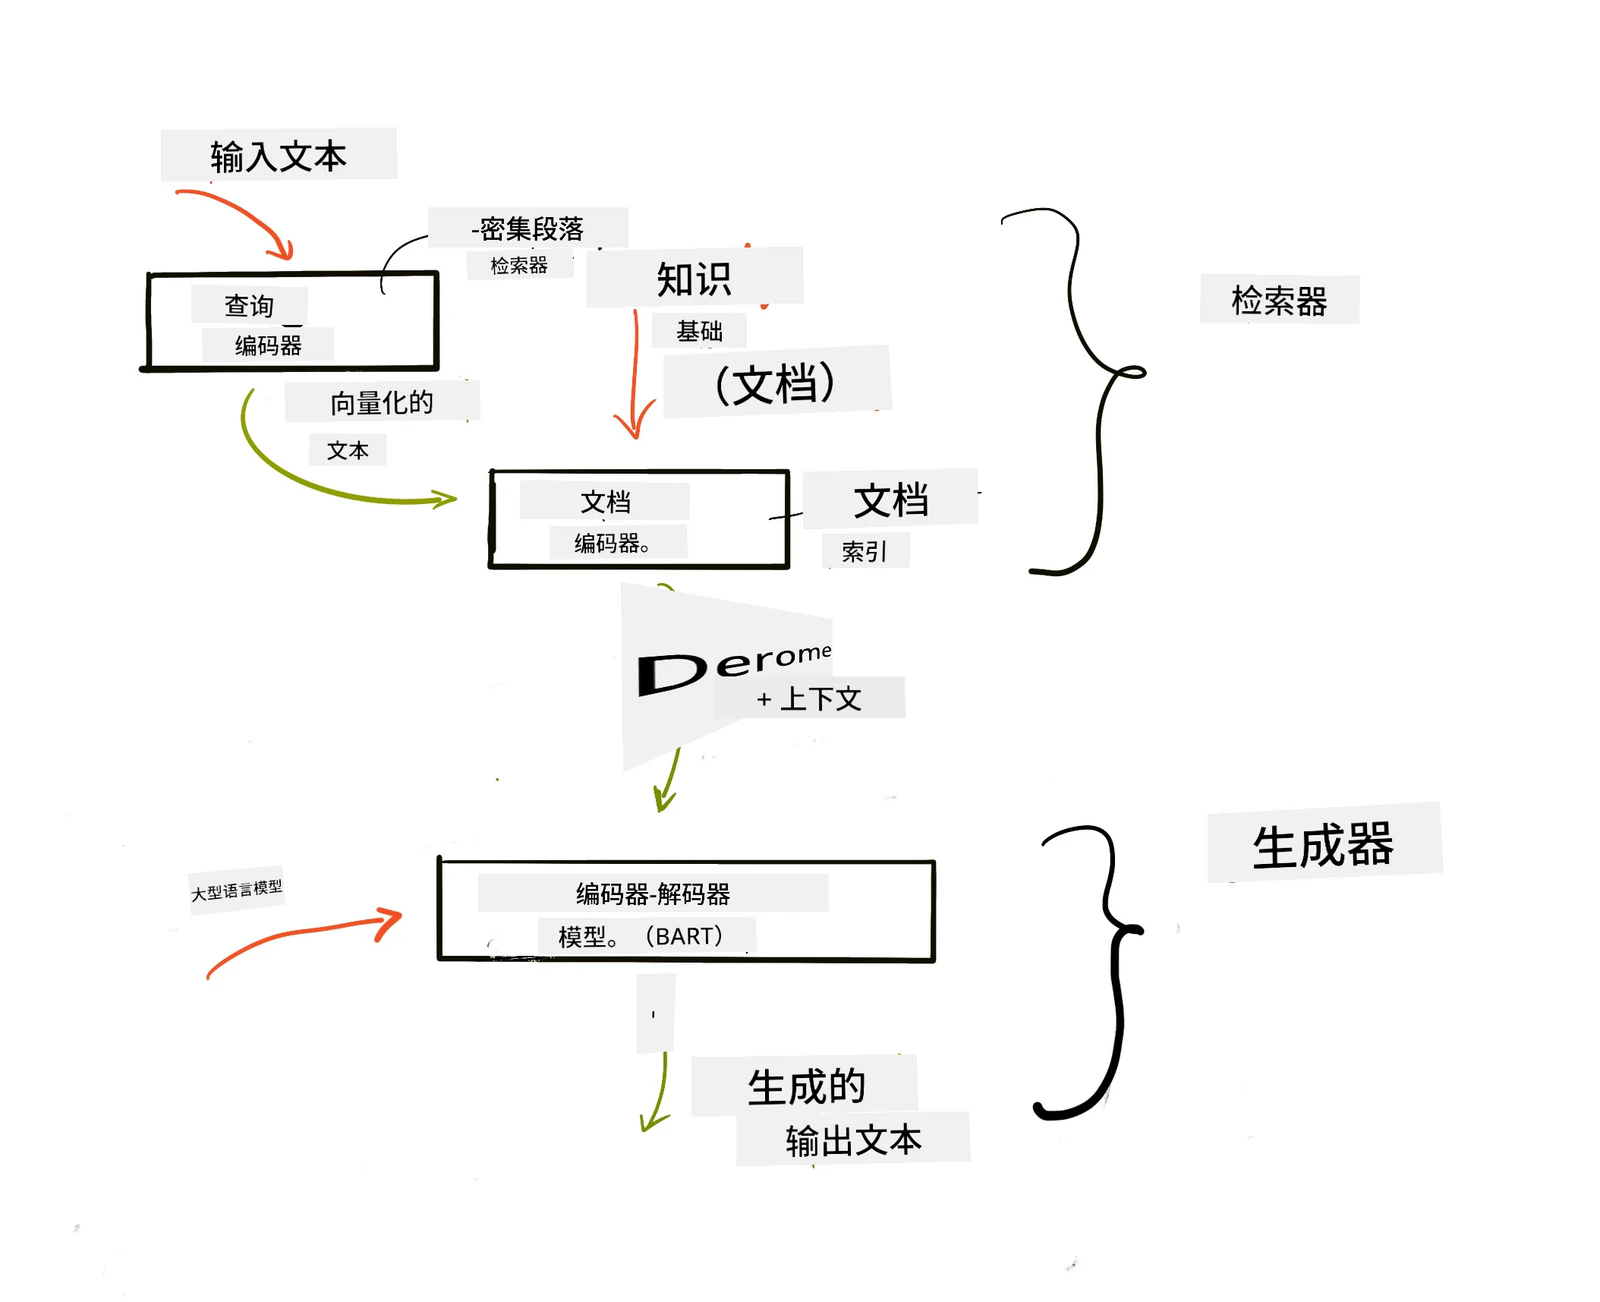
编者注:此图中文由机器翻译生成,中间的“Derome”是机器翻译留下的乱码,整体结构请以正文为准。
RAG 的架构用 Transformer 实现,由编码器和解码器两部分组成。例如,用户提问时,输入文本会被“编码”成捕捉词语含义的向量,这些向量再被“解码”到我们的文档索引中,并根据用户的查询生成新的文本。LLM 同时使用编码器-解码器模型来生成输出。
根据提出 RAG 的论文 Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(《面向知识密集型自然语言处理任务的检索增强生成》),实现 RAG 有两种方法:
-
RAG-Sequence:用检索到的文档预测用户查询的最佳答案。
-
RAG-Token:用文档生成下一个 token,再检索文档来回答用户的查询。
为什么要用 RAG?
-
信息丰富: 确保文字回答是最新的。它通过访问内部知识库,提升模型在特定领域任务上的表现。
-
利用知识库中的可核实数据为用户的查询提供上下文,减少编造。
-
性价比高: 与微调 LLM 相比,RAG 更经济。
创建知识库
我们的应用基于我们自己的数据,也就是《AI for Beginners》课程中关于神经网络的那一课。
向量数据库
向量数据库不同于传统数据库,是一种专门用来存储、管理和搜索嵌入向量的数据库。它存储的是文档的数值表示。把数据拆分成数值形式的嵌入,能让我们的 AI 系统更容易理解和处理这些数据。
我们之所以把嵌入存进向量数据库,是因为 LLM 能接收的输入 token 数量有限。既然不能把全部嵌入都交给 LLM,就需要把数据拆分成块;用户提问时,与问题最相似的那些块会和提示词一起返回。分块还能减少传给 LLM 的 token 数量,从而降低成本。
常见的向量数据库有 Azure Cosmos DB、Clarifyai、Pinecone、Chromadb、ScaNN、Qdrant 和 DeepLake。你可以用 Azure CLI 创建 Azure Cosmos DB。
编者注:此处原有一段 Azure CLI 命令示例(登录 Azure、创建资源组和 Cosmos DB 账户并列出访问密钥),本库从略。
从文本到嵌入
在存储数据之前,需要先把它转换成向量嵌入。如果处理的是大文档或长文本,可以根据预期的查询来分块。分块可以按句子,也可以按段落。由于一个块的含义要从它周围的词中推断,你可以给块补充一些上下文,比如加上文档标题,或者带上块前后的一些文字。
编者注:此处原有一段 Python 示例代码,演示按长度上下限把一段文本切成若干块,本库从略。
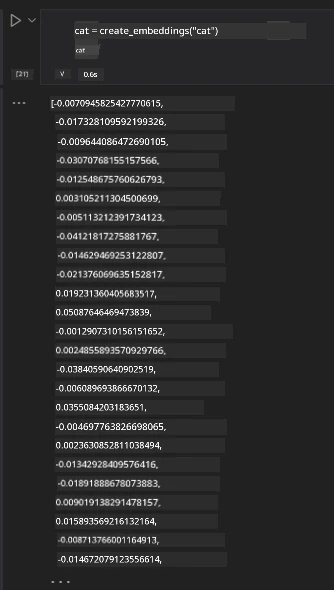
分块之后,就可以用不同的嵌入模型把文本转换成嵌入。可用的模型有 word2vec、OpenAI 的 ada-002、Azure 计算机视觉等等。选用哪个模型,取决于你使用的语言、要编码的内容类型(文本、图像还是音频)、模型能编码的输入长度以及嵌入输出的长度。
下面是用 OpenAI 的 text-embedding-ada-002 模型对文本做嵌入的一个例子:
检索和向量搜索
用户提问时,检索器用查询编码器把问题转换成向量,然后在我们的文档搜索索引中查找与输入相关的向量。完成之后,它把输入向量和文档向量都转换回文本,交给 LLM。
检索
检索是指系统设法从索引中快速找出符合搜索条件的文档。检索器的目标是取得一些文档,用来提供上下文,让 LLM 以你的数据为依据作答。
在数据库中搜索有几种方式,例如:
-
关键词搜索:用于文本搜索。
-
向量搜索:用嵌入模型把文档从文本转换成向量表示,从而可以根据词语的含义做语义搜索。检索时,查找向量表示与用户问题最接近的那些文档。
-
混合搜索:把关键词搜索和向量搜索结合起来。
检索的一个难点在于:如果数据库中没有与查询相似的内容,系统会返回它能找到的最佳信息。不过,你可以采用一些策略,比如设定相关性的最大距离,或者使用结合关键词和向量搜索的混合搜索。本课我们使用混合搜索,即向量搜索和关键词搜索的结合。我们会把数据存进一个 DataFrame(数据表),其中的列包含文本块和对应的嵌入。
向量相似度
检索器会在知识库中寻找彼此靠近的嵌入,也就是最近邻,因为它们对应的是相似的文本。用户提出查询时,查询会先被转成嵌入,再与相似的嵌入进行匹配。衡量不同向量有多相似,常用的指标是余弦相似度,它基于两个向量之间的夹角。
衡量相似度还有其他方法,比如欧氏距离,即两个向量端点之间的直线距离;以及点积,即两个向量对应元素乘积之和。
搜索索引
做检索时,需要先为知识库建立搜索索引,然后才能搜索。索引会存储我们的嵌入,即使数据库很大,也能快速找出最相似的块。我们可以在本地创建索引。
编者注:此处原有一段 Python 示例代码,演示用 scikit-learn 的最近邻算法为全部嵌入建立索引,本库从略。
重新排序
查询数据库之后,你可能需要把结果按相关程度从高到低排序。重新排序用的 LLM 利用机器学习,把搜索结果按相关程度排列,从而提高结果的相关性。使用 Azure AI Search 时,语义重新排序器会自动帮你完成重新排序。
编者注:此处原有一段 Python 示例代码,演示用最近邻算法找出与查询最相似的几个文档并逐条打印,本库从略。
整合起来
最后一步是把 LLM 加进来,让它给出以我们的数据为依据的回答。
编者注:此处原有一段 Python 示例代码,演示把用户问题(示例为“什么是感知机?”)转成查询向量,找出最相似的几个文本块,再把它们和问题一起作为提示词发给模型生成回答,本库从略。
评估我们的应用
评估指标
-
回答的质量:确保回答听起来自然、流畅,像人写的。
-
数据的有据性(groundedness):评估回答是否来自所提供的文档。
-
相关性:评估回答是否切合所提的问题。
-
流畅度:回答在语法上是否通顺。
RAG(检索增强生成)和向量数据库的应用场景
在很多不同的场景中,RAG 和向量数据库都能改进你的应用,例如:
编者注:英文原文此句写的是“函数调用”(function calls),疑为笔误,这里按本课主题译为 RAG 和向量数据库。
-
问答:让聊天机器人以公司数据为依据,供员工提问。
-
推荐系统:建立一个匹配最相似内容的系统,例如电影、餐馆等等。
-
聊天机器人服务:保存聊天记录,根据用户数据提供个性化的对话。
-
基于向量嵌入的图像搜索:适用于图像识别和异常检测。
总结
我们介绍了 RAG 的基本内容,从把数据加入应用,到用户查询和输出。想更简单地搭建 RAG,可以使用 Semantic Kernel、LangChain 或 AutoGen 等框架。
作业
想继续学习检索增强生成(RAG),你可以:
-
用你选择的框架为这个应用构建前端。
-
使用 LangChain 或 Semantic Kernel 框架,重新实现你的应用。
恭喜你学完本课 👏。
学习不止于此,继续前行
学完本课后,可以看看原课程推荐的生成式 AI 学习合集,继续提升你对生成式 AI 的了解。
免责声明:本课中文原由 AI 翻译服务 Co-op Translator 机器翻译,本库已对照英文原文校订,并有删节。中英文如有出入,以英文原版为准。