
AI 学习资料 · 生成式 AI 入门(精选 7 课)
探索和比较不同的大语言模型(LLM)
在上一课中,我们已经了解了生成式人工智能如何改变技术格局、大语言模型(LLM)如何工作,以及企业(比如我们的初创企业)如何把它们用到自己的场景中并实现增长!本课我们将比较不同类型的大语言模型,了解它们各自的优缺点。
我们初创企业的下一步,是了解当前的 LLM 格局,弄清楚哪些模型适合我们的场景。
简介
本课将涵盖:
- 当前格局下不同类型的 LLM。
- 在 Azure 中针对你的场景测试、迭代和比较不同模型。
- 如何部署 LLM。
学习目标
完成本课后,你将能够:
- 为你的场景选择合适的模型。
- 了解如何测试、迭代并提升模型的表现。
- 了解企业如何部署模型。
了解不同类型的 LLM
LLM 可以按架构、训练数据和用途进行多种分类。了解这些差异,有助于我们的初创企业为场景选择合适的模型,并理解如何测试、迭代和提升表现。
LLM 有许多不同类型,选择哪种模型,取决于你打算用它做什么、你的数据、你愿意花多少钱等因素。
根据你打算生成的是文本、音频、视频还是图像等,你可能会选择不同类型的模型。
-
音频与语音识别。Whisper 一类的模型仍是实用的通用语音识别模型,但如今生产环境中还可以选择更新的语音转文字模型,比如
gpt-4o-transcribe、gpt-4o-mini-transcribe,以及带说话人分离功能的版本。请结合你的场景评估语言覆盖、说话人分离、实时支持、延迟和成本。更多内容请参见 OpenAI 语音转文字文档。 -
图像生成。DALL-E 和 Midjourney 是知名的图像生成选择,但目前 OpenAI 的图像 API 以
gpt-image-2等 GPT Image 模型为主,Stable Diffusion、Imagen、Flux 及其他模型家族也是常见选择。请比较它们对提示词的遵循程度、编辑支持、风格控制、安全要求和许可条款。更多信息请参见 OpenAI 图像生成指南,以及原课程第 9 课(本库未收录)。 -
文本生成。如今的文本模型涵盖前沿模型、推理模型、小型低延迟模型和开放权重模型。当前的例子包括 OpenAI GPT-5.x 系列、Anthropic Claude 4.x 系列、Google Gemini 3.x 系列、Meta Llama 4 系列,以及 Mistral 的模型。不要只看发布日期或价格来选择,而要比较任务质量、延迟、上下文窗口、工具调用、安全表现、地区可用性和总成本。Microsoft Foundry 模型目录是比较 Azure 上可用模型的好去处。
-
多模态。许多当前模型能处理文本以外的内容。有些可以接收图像、音频或视频输入;有些能调用工具;专用模型还能生成图像、音频或视频。例如,当前的 OpenAI 模型支持文本和图像输入;Gemini 模型视具体版本,可支持文本、代码、图像、音频和视频输入;Llama 4 Scout 和 Maverick 是原生多模态的开放权重模型。在围绕某个模型搭建工作流之前,务必查看它的模型卡,确认支持哪些输入和输出模态。
选定一个模型,意味着你获得了一些基本能力,但这可能还不够。很多时候,你手里有公司特有的数据,需要设法让 LLM 知道。处理这个问题有几种不同的做法,后面几节会详细介绍。
基础模型与 LLM
“基础模型”(Foundation Model)这一术语由斯坦福研究人员提出,指满足以下一些标准的 AI 模型:
- 它们通过无监督学习或自监督学习训练,也就是在未标注的多模态数据上训练,训练过程不需要人工注释或标注数据。
- 它们是非常大的模型,基于非常深的神经网络,参数量达数十亿。
- 它们通常用作其他模型的“基础”,也就是说,可以作为起点,在其上构建其他模型,方法之一是微调。
图略:基础模型与大语言模型的对比示意图(来源:Essential Guide to Foundation Models and Large Language Models | by Babar M Bhatti | Medium)
为了把这个区别说得更清楚,我们以 ChatGPT 的早期历史为例。早期版本的 ChatGPT 以 GPT-3.5 作为基础模型。之后,OpenAI 用对话专用的数据和对齐技术,打造出一个在对话场景(如聊天机器人)中表现更好的调优版本。如今的 AI 服务常常在多个模型版本之间路由,所以服务名称和底层模型名称不一定是一回事。
图略:基础模型示意图(来源:2108.07258.pdf (arxiv.org))
开放权重/开源模型与专有模型
LLM 的另一种分类方式,是看它属于开放权重模型、开源模型,还是专有模型。
开源模型和开放权重模型会公开模型文件,供人检查、下载或定制,但它们的许可证各不相同:有些完全开源,有些则是带使用限制的开放权重模型。当企业需要更多地掌控部署方式、数据存放位置、成本或定制时,它们很有用。不过,团队在投入生产之前,仍需审查许可条款、运行成本、维护、安全更新和评估质量。例子包括 Meta Llama 4、部分 Mistral 模型,以及托管在 Hugging Face 上的许多模型。
专有模型由供应商拥有和托管。这类模型通常针对托管式的生产使用做了优化,能提供有力的支持、安全机制、工具集成和扩展能力。但客户通常无法检查或修改模型权重,还要查看供应商关于隐私、数据保留、合规和可接受使用的条款。例子包括 OpenAI 模型、Google Gemini 和 Anthropic Claude。
嵌入、图像生成与文本和代码生成
LLM 也可以按生成的输出来分类。
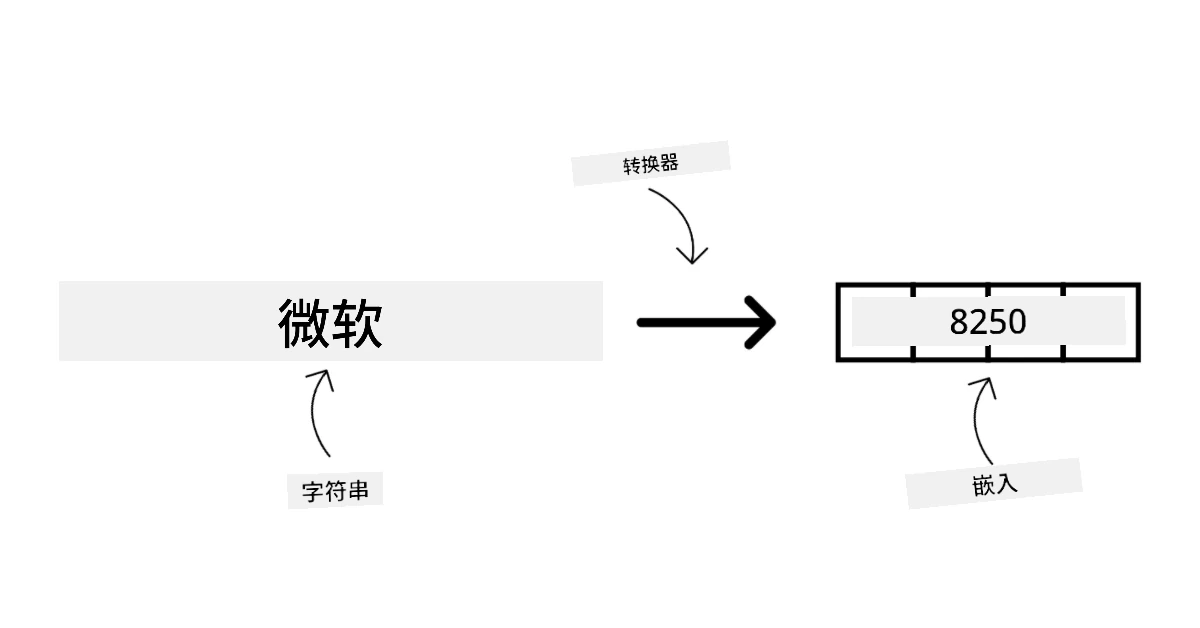
嵌入(Embedding)模型是一类能把文本转换成数值形式的模型,这种数值形式称为嵌入,是输入文本的数值表示。嵌入让机器更容易理解单词或句子之间的关系,也可以作为其他模型的输入,比如在数值数据上表现更好的分类模型或聚类模型。嵌入模型常用于迁移学习:先针对一个数据充足的替代任务构建模型,再把模型权重(嵌入)复用到其他下游任务上。这一类的例子是 OpenAI embeddings。
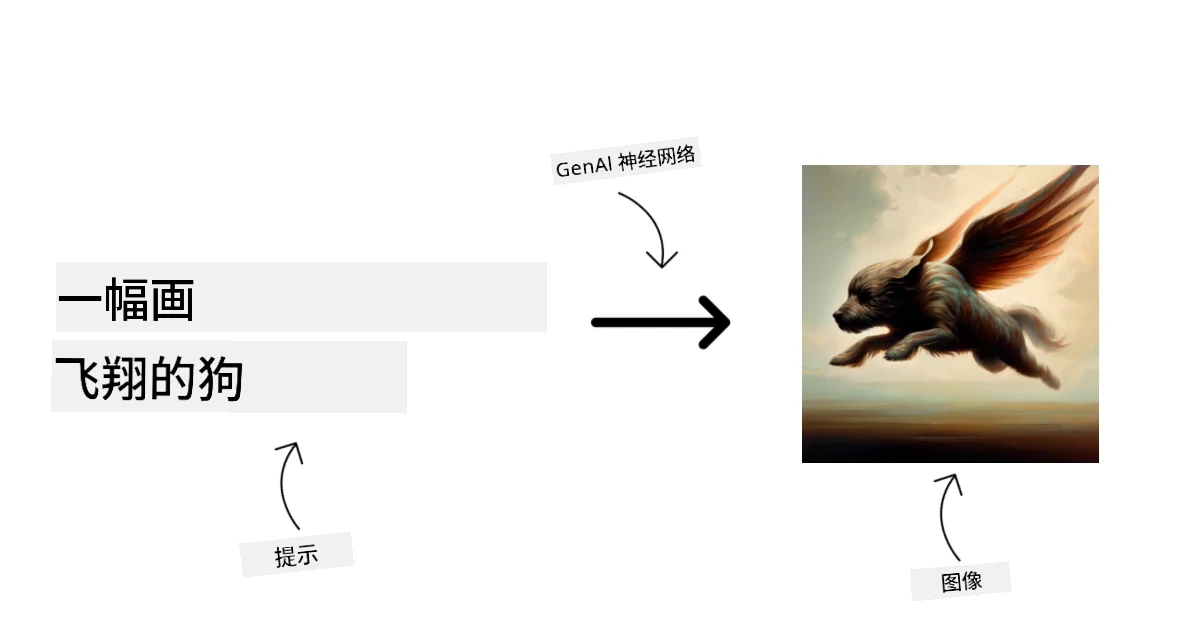
图像生成模型是生成图像的模型,常用于图像编辑、图像合成和图像转换。图像生成模型通常在大型图像数据集(如 LAION-5B)上训练,可以生成新图像,也可以用局部重绘(inpainting)、超分辨率、上色等技术编辑现有图像。例子包括 GPT Image 模型、Stable Diffusion 模型和 Imagen 模型。
文本和代码生成模型是生成文本或代码的模型,常用于文本摘要、翻译和问答。文本生成模型通常在大型文本数据集(如 BookCorpus)上训练,可以生成新文本或回答问题。代码生成模型,如 CodeParrot,通常在大型代码数据集(例如来自 GitHub 的代码)上训练,可以生成新代码,或修复现有代码中的错误。
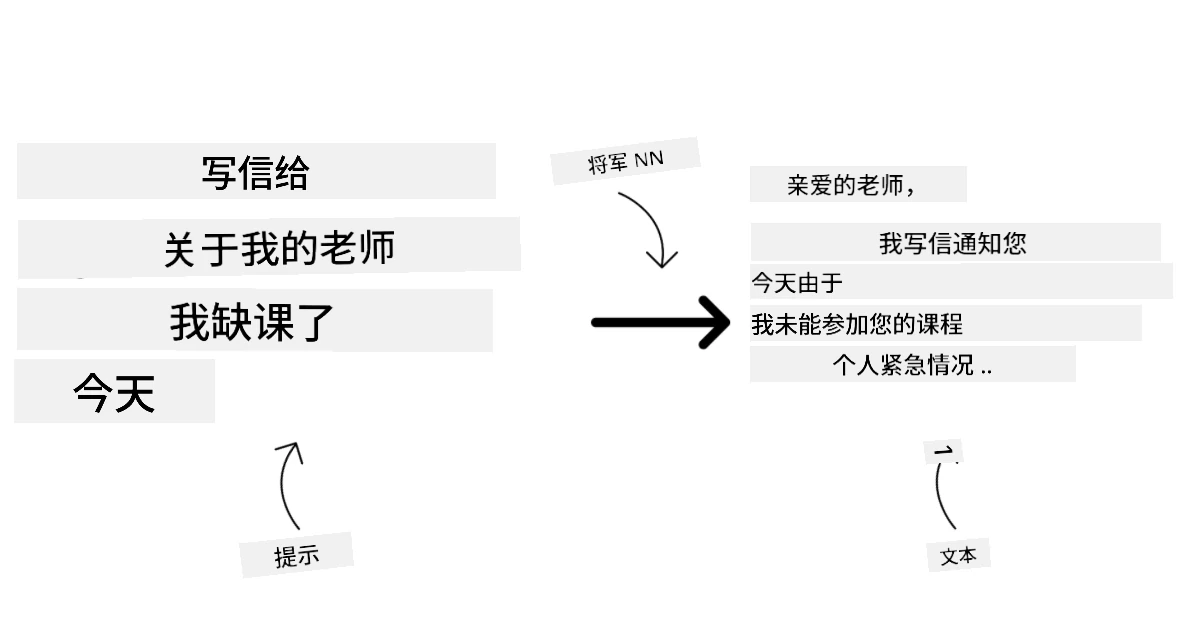
编者注:此图中的“将军 NN”是机器翻译错误,对照上一张图,应为“GenAI 神经网络”,即生成式 AI 的神经网络。
编码器-解码器架构与仅解码器架构
为了说明 LLM 的不同架构,我们打个比方。
假设经理交给你一项任务:给学生出一份测验题。你有两位同事,一位负责编写内容,另一位负责审核。
编写内容的同事就像仅解码器(decoder-only)模型:他们会看主题,看你已经写了什么,然后根据这些上下文继续写下去。他们很擅长写出有吸引力、信息量大的内容,但如果任务只是对信息做分类、检索或编码,他们就不一定是最佳人选。仅解码器模型家族的例子有 GPT 和 Llama。
审核的同事就像仅编码器(encoder-only)模型:他们看已经写好的课程内容和答案,注意到两者之间的关系,理解上下文,但不擅长生成内容。仅编码器模型的一个例子是 BERT。
再假设有一个人既能出题又能审核,这就是编码器-解码器(encoder-decoder)模型。例子有 BART 和 T5。
服务与模型
接下来谈谈服务和模型的区别。服务是云服务提供商提供的产品,通常由模型、数据和其他组件组合而成。模型是服务的核心组件,通常是基础模型,比如 LLM。
服务通常针对生产使用做了优化,而且往往有图形界面,比直接使用模型更容易上手。但服务不一定免费,可能需要订阅或付费;作为交换,你可以使用服务方的设备和资源,节省开支、轻松扩展。服务的一个例子是 Azure OpenAI Service,它提供按用量付费(pay-as-you-go)的计费方案,即按实际使用量收费。在模型能力之外,Azure OpenAI Service 还提供企业级安全保障和负责任 AI 框架。
模型是神经网络的产物:参数、权重、架构、分词器以及配套的配置。要在本地或私有环境中运行模型,需要合适的硬件、模型服务基础设施和监控,还需要相应的开源/开放权重许可或商业许可。Llama 4、Mistral 等开放权重模型可以自行托管,但仍需要算力和运维能力。
如何在 Azure 上测试和迭代不同模型,了解它们的表现
我们的团队了解了当前的 LLM 格局,并为自己的场景挑出了一些不错的候选模型之后,下一步就是在自己的数据和工作负载上测试它们。这是一个通过实验和测量反复迭代的过程。前面提到的大多数模型(OpenAI 模型、Llama 4 和 Mistral 等开放权重模型,以及 Hugging Face 上的模型)都可以在 Microsoft Foundry Models 中找到。
Microsoft Foundry(前身为 Azure AI Studio/Azure AI Foundry)是 Azure 上用于构建 AI 应用和智能体的统一平台。它帮助开发者管理从实验、评估到部署、监控和治理的整个生命周期。用户可以通过 Microsoft Foundry 的模型目录:
编者注:本节截图拍摄于平台更名前的 Azure AI Studio,界面与现在的 Microsoft Foundry 会有出入;图中中文由机器翻译生成,部分文字不准确。
- 在目录中查找感兴趣的基础模型,包括由 Azure 销售的模型,以及来自合作伙伴和社区提供者的模型。可以按任务、提供者、许可证、部署选项或名称筛选。
图略:Azure AI Studio 模型目录页面的截图,页面上是各家模型的卡片和筛选栏(来源:原课程配图,见原课程第 2 课)
- 查看模型卡,包括对预期用途和训练数据的详细说明、代码示例,以及在内部评估库上的评估结果。
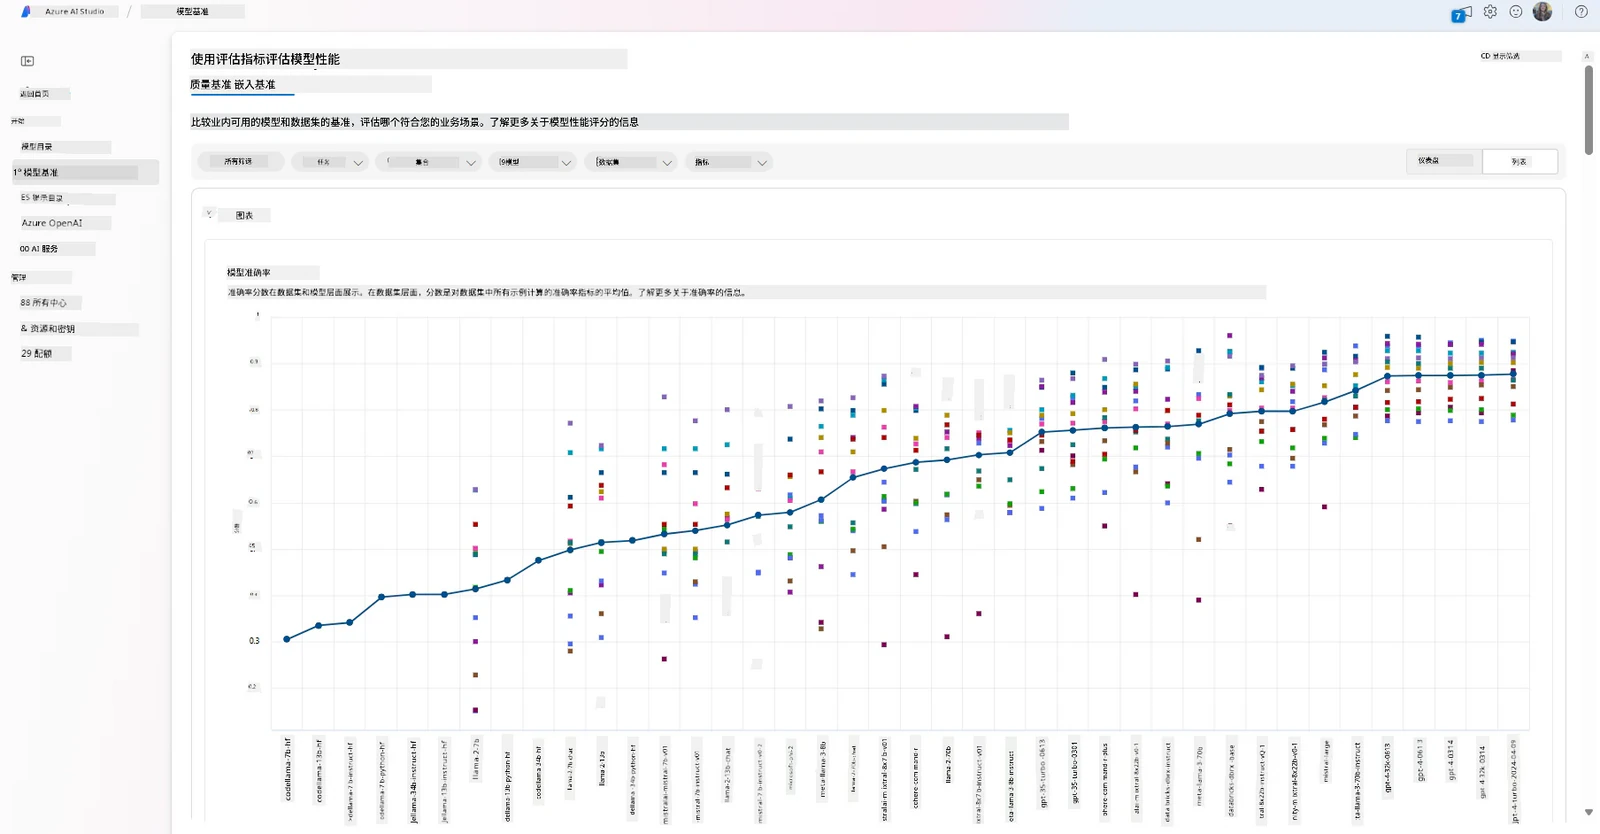
- 通过模型基准测试面板,比较业内各模型在各数据集上的基准成绩,评估哪个模型符合业务场景。
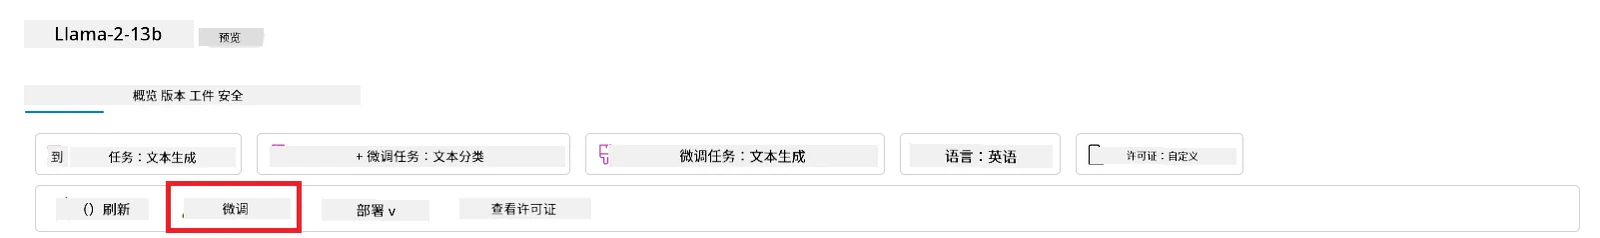
- 利用 Microsoft Foundry 的实验和跟踪功能,用自定义训练数据微调受支持的模型,提升模型在特定工作负载上的表现。
- 使用托管计算或无服务器部署选项,把原始的预训练模型或微调后的版本部署到远程实时推理端点,供应用程序调用。
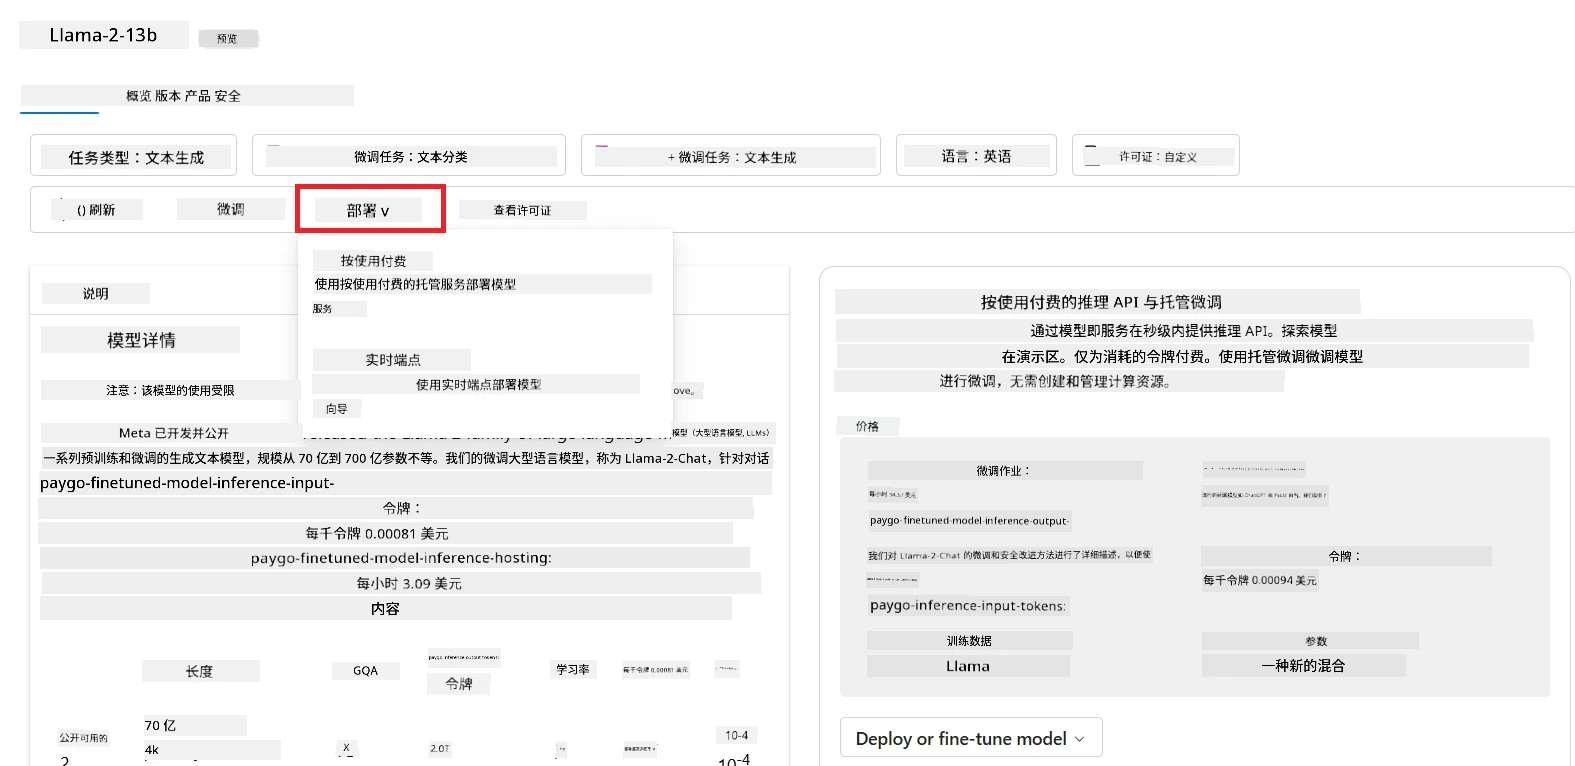
注意:目录中并非所有模型目前都支持微调或按用量付费部署。请查看模型卡,了解模型的能力和限制。
提升 LLM 的结果
我们和初创团队一起了解了不同类型的 LLM,以及一个云平台(Microsoft Foundry)。借助这个平台,我们可以比较不同模型、在测试数据上评估它们、提升表现,并把它们部署到推理端点。
但什么时候应该考虑微调模型,而不是直接使用预训练模型?还有没有其他方法能提升模型在特定工作负载上的表现?
企业可以用多种方法从 LLM 获得所需的结果。在生产环境中部署 LLM 时,可以选择训练程度不同的各类模型,它们的复杂度、成本和质量各不相同。下面是几种不同的方法:
-
带上下文的提示词工程。思路是在提示词中提供足够的上下文,确保得到你需要的回答。
-
检索增强生成(RAG)。你的数据可能存放在数据库或某个网络端点中。为了确保向模型发提示词时带上这些数据(或其中一部分),可以先检索出相关数据,把它们放进用户的提示词。
-
微调模型。这种做法是用你自己的数据进一步训练模型,让模型更准确、更贴合你的需求,但成本可能较高。
图略:企业部署 LLM 的几种方式示意图(来源:Four Ways that Enterprises Deploy LLMs | Fiddler AI Blog)
带上下文的提示词工程
预训练的 LLM 在通用的自然语言任务上表现很好,即使只给一个简短的提示词(比如一句待补全的话或一个问题)也是如此,这就是所谓的“零样本”(zero-shot)学习。
不过,用户越能把问题框定清楚,给出详细的要求和示例(也就是上下文),得到的答案就越准确、越接近期望。如果提示词中只有一个示例,称为“单样本”(one-shot)学习;如果有多个示例,称为“少样本”(few-shot)学习。带上下文的提示词工程是起步时性价比最高的方法。
检索增强生成(RAG)
LLM 有一个局限:它们只能用训练时用过的数据来生成答案。这意味着它们对训练结束后发生的事一无所知,也无法访问非公开信息(比如公司数据)。RAG 可以克服这个问题。这种技术在不超出提示词长度限制的前提下,把外部数据以文档片段(chunk)的形式补充到提示词中。它依靠向量数据库工具(如 Azure Vector Search)从各种预先指定的数据源中检索出有用的片段,再把它们加入提示词的上下文。
当企业没有足够的数据、时间或资源来微调 LLM,但仍希望提升特定工作负载上的表现,并降低出现幻觉、过时或缺乏依据的回答的风险时,这种技术非常有用。
微调模型
微调是借助迁移学习,让模型“适应”某个下游任务或解决某个具体问题的过程。与少样本学习和 RAG 不同,微调会产生一个新模型,其权重和偏置都已更新。它需要一组训练样本,每个样本由一个输入(提示词)和对应的输出(补全)组成。在以下情况下,微调是首选做法:
-
使用更小的专用模型。企业希望针对一项范围很窄的任务微调一个较小的模型,而不是每次都用提示词去调用一个更大的前沿模型,从而得到成本更低、速度更快的方案。
-
考虑延迟。某个场景对延迟要求很高,因此不能使用很长的提示词;或者需要模型学习的示例太多,超出了提示词长度限制。
-
固定稳定的行为。企业有大量高质量示例,希望模型始终遵循某种任务模式、输出格式、语气或领域风格。如果主要问题是需要最新事实,或是经常变化的私有知识,就应该使用 RAG,而不是只依赖微调。
自行训练模型
从头训练一个 LLM 无疑是最困难、最复杂的做法,需要海量数据、专业人才和相应的算力。只有当企业有特定领域的用例,并且拥有大量该领域的数据时,才应考虑这个选项。
知识测试
哪些方法可以有效改善 LLM 的补全结果?
- 带上下文的提示词工程
- RAG
- 微调模型
答:三种都有帮助。想快速见效,先从提示词工程和上下文入手;当模型需要最新事实或企业私有数据时,使用 RAG;当你有足够多的高质量示例,并且需要模型始终遵循某种任务、格式、语气或领域模式时,选择微调。
🚀 挑战
进一步了解如何为你的业务使用 RAG。
做得好,继续学习
学完本课后,可以看看原课程推荐的生成式 AI 学习合集,继续提升你对生成式 AI 的了解。
下一课(第 3 课)我们将学习如何负责任地使用生成式 AI 进行构建。
免责声明:本课中文原由 AI 翻译服务 Co-op Translator 机器翻译,本库已对照英文原文校订,并有删节。中英文如有出入,以英文原版为准。