
AI 学习资料 · 生成式 AI 入门(精选 7 课)
提示词工程基础
介绍
本模块介绍在生成式 AI 模型中写出有效提示词的基本概念和技术。你怎样给大语言模型(LLM)写提示词也很重要,精心设计的提示词能得到质量更好的回答。但提示词和提示词工程这些术语到底是什么意思?我又该如何改进发送给 LLM 的提示词输入?这些就是本课和下一课要尝试回答的问题。
生成式 AI 能够根据用户的请求创作新内容(例如文本、图像、音频、代码等)。它依靠的是大语言模型,比如 OpenAI 的 GPT(Generative Pre-trained Transformer,生成式预训练 Transformer)系列,这些模型经过训练,能够使用自然语言和代码。
现在,用户可以用聊天这类熟悉的方式与这些模型互动,不需要任何技术专长或培训。这些模型是基于提示词的:用户发送一段文本输入(提示词),得到 AI 的回答(补全)。之后,用户可以在多轮对话中反复“和 AI 聊天”,不断完善提示词,直到回答符合预期。
“提示词”如今成了生成式 AI 应用的主要编程接口:它告诉模型要做什么,并影响返回的回答质量。“提示词工程”是一个快速发展的研究领域,专注于提示词的设计和优化,以便大规模地稳定输出高质量的回答。
学习目标
在本课中,我们将学习什么是提示词工程、它为什么重要,以及如何针对给定的模型和应用目标,写出更有效的提示词。我们会了解提示词工程的核心概念和最佳实践,并认识一个交互式的 Jupyter Notebook“沙盒”环境,在其中看到这些概念如何应用到真实示例中。
学完本课,我们将能够:
- 解释什么是提示词工程,以及它为什么重要。
- 描述提示词由哪些部分组成,以及各部分如何使用。
- 学习提示词工程的最佳实践和技术。
- 使用 OpenAI 端点,把学到的技术应用到真实示例中。
关键术语
- 提示词工程:设计和完善输入,引导 AI 模型产生期望输出的做法。
- 分词(Tokenization):把文本转换成更小的单位(称为 token),以便模型理解和处理的过程。
- 指令调优的 LLM:用特定指令微调过、以提高回答准确性和相关性的大语言模型。
学习沙盒
提示词工程目前更像一门艺术,而不是科学。提升这方面直觉的最好办法是多练习,采用试错的方法,把应用领域的专业知识、推荐的技术和针对具体模型的优化结合起来。
本课配套的 Jupyter Notebook 提供了一个沙盒环境,你可以边学边试,也可以在课程结尾的代码挑战中使用它。要运行这些练习,你需要:
- 一个 Azure OpenAI API 密钥:已部署的 LLM 的服务端点。
- 一个 Python 运行环境:用来运行 Notebook。
- 本地环境变量:现在就完成设置步骤(英文),做好准备。
Notebook 里附有入门练习,也鼓励你自己添加 Markdown(说明)和代码(提示词请求)部分,尝试更多示例或想法,培养提示词设计的直觉。
编者注:本库只收录课程正文,没有收录配套的 Notebook。需要动手练习的读者,可到原课程第 4 课的仓库目录中获取。
图解指南
想在深入学习之前先了解本课的全貌吗?看看这份图解指南,它展示了本课的主要主题,以及每个主题中值得你思考的要点。本课的路线是:先理解核心概念和挑战,再用相关的提示词工程技术和最佳实践来应对。请注意,图中“高级技术”部分指的是本课程下一课的内容。
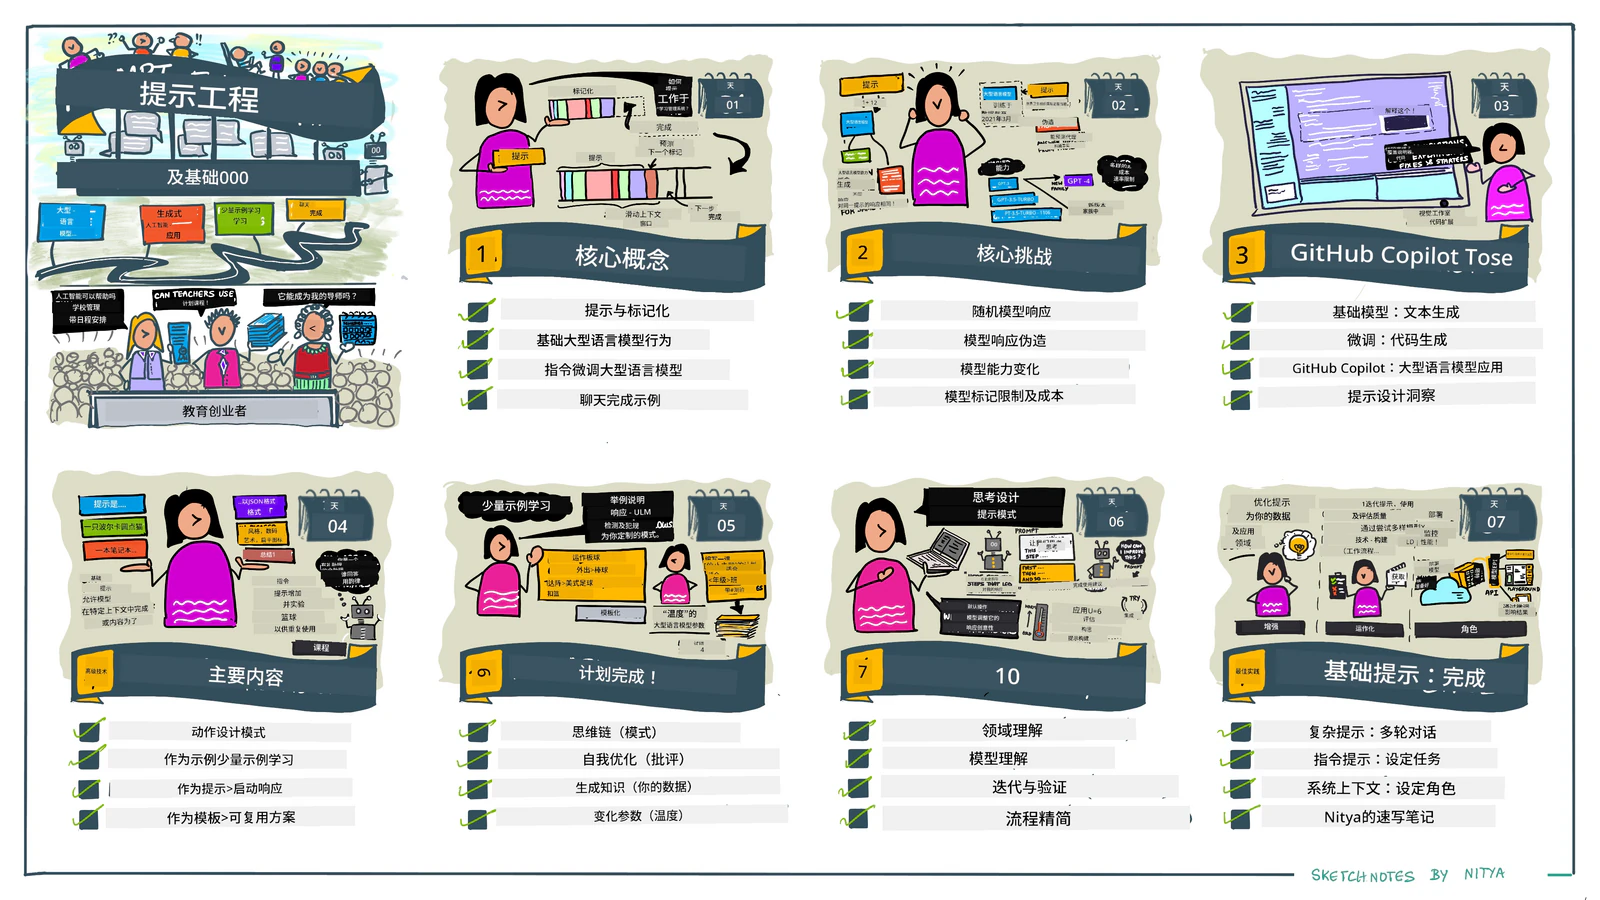
编者注:这是一幅手绘速写笔记(右下角有作者署名 Nitya),图中中文由机器翻译生成,有些标注不通或有误,内容以正文为准。
我们的初创企业
现在来谈谈这个主题与我们初创企业的使命——把 AI 创新带入教育——有什么关系。我们想构建由 AI 驱动的个性化学习应用,所以先想想应用的不同用户可能会怎样“设计”提示词:
- 管理人员可能会让 AI 分析课程数据,找出内容覆盖上的空白。AI 可以总结结果,或用代码把结果可视化。
- 教师可能会让 AI 针对特定对象和主题生成教案。AI 可以按指定格式制定个性化的教案。
- 学生可能会让 AI 辅导他们学习一门难懂的科目。AI 可以根据学生的水平,用课程讲解、提示和示例来引导他们。
这只是冰山一角。看看由教育专家整理的开源提示词库 Prompts For Education,你会对各种可能性有更全面的认识!试着在沙盒中或用 OpenAI Playground 运行其中一些提示词,看看会发生什么!
什么是提示词工程?
本课开头把提示词工程定义为:针对给定的应用目标和模型,设计和优化文本输入(提示词),以稳定地获得高质量回答(补全)的过程。可以把它看作两个步骤:
- 针对给定的模型和目标,设计最初的提示词
- 反复完善提示词,提高回答的质量
这必然是一个试错的过程,需要用户的直觉和投入才能得到最佳结果。那么,它为什么重要?要回答这个问题,我们首先需要理解三个概念:
- 分词 = 模型如何“看到”提示词
- 基础 LLM = 基础模型如何“处理”提示词
- 指令调优的 LLM = 模型如何开始理解“任务”
分词
LLM 把提示词看作一串 token 序列,而不同的模型(或同一模型的不同版本)可能会用不同的方式对同一个提示词分词。由于 LLM 是在 token(而不是原始文本)上训练的,提示词的分词方式会直接影响生成回答的质量。
想直观地了解分词是怎么回事,可以试试下图所示的 OpenAI Tokenizer 等工具。把你的提示词复制进去,看看它如何被转换成 token,尤其留意空白字符和标点符号是怎么处理的。注意,这个示例用的是较旧的 LLM(GPT-3),用更新的模型试,结果可能不同。
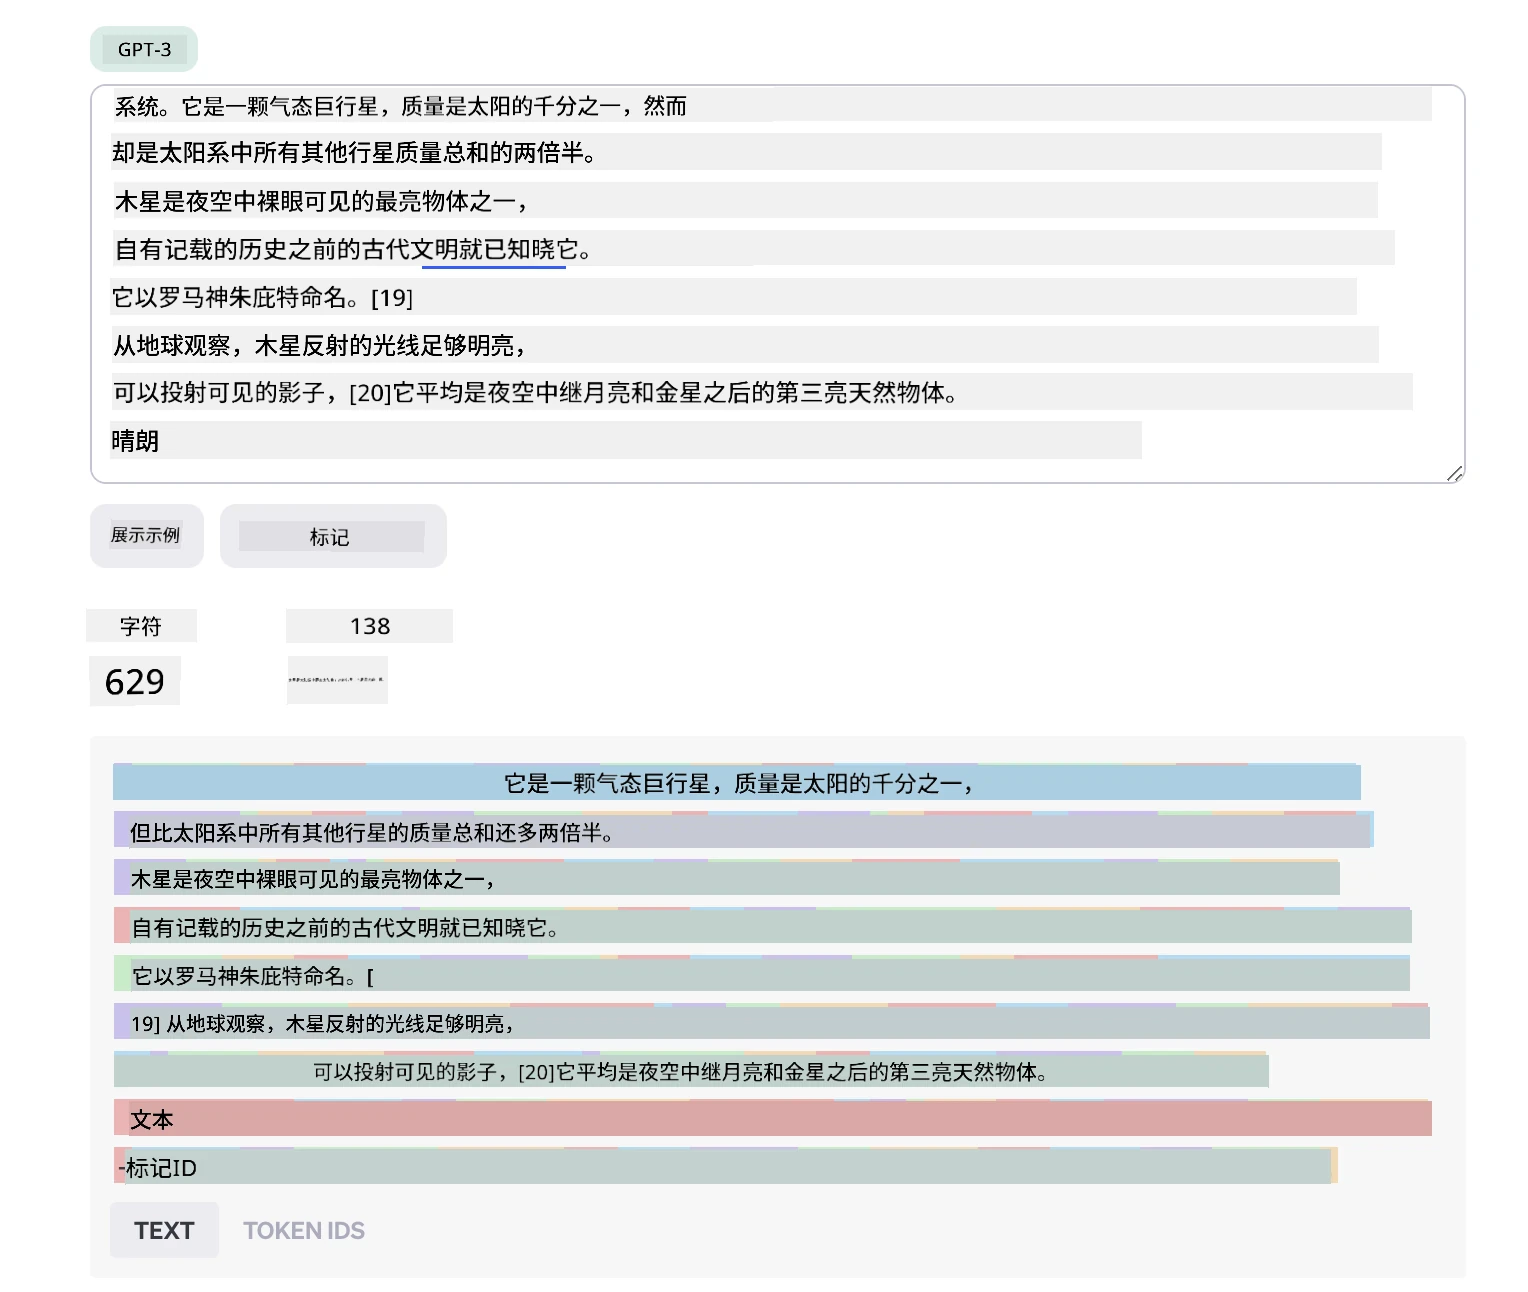
编者注:此图中文由机器翻译生成,只替换了图中的文字。图中的字符数和 token 数与中文文字对不上,应是英文原图的统计结果。
概念:基础模型
提示词被分词之后,“基础 LLM”(也就是基础模型)的主要功能,就是预测这个序列中的下一个 token。由于 LLM 是在海量文本数据集上训练的,它们很清楚 token 之间的统计关系,能以一定的把握做出预测。注意,它们并不理解提示词或 token 中词语的含义,只是看到一个可以用下一次预测来“补全”的模式。它们可以一直预测下去,直到用户干预或满足某个预设条件才停止。
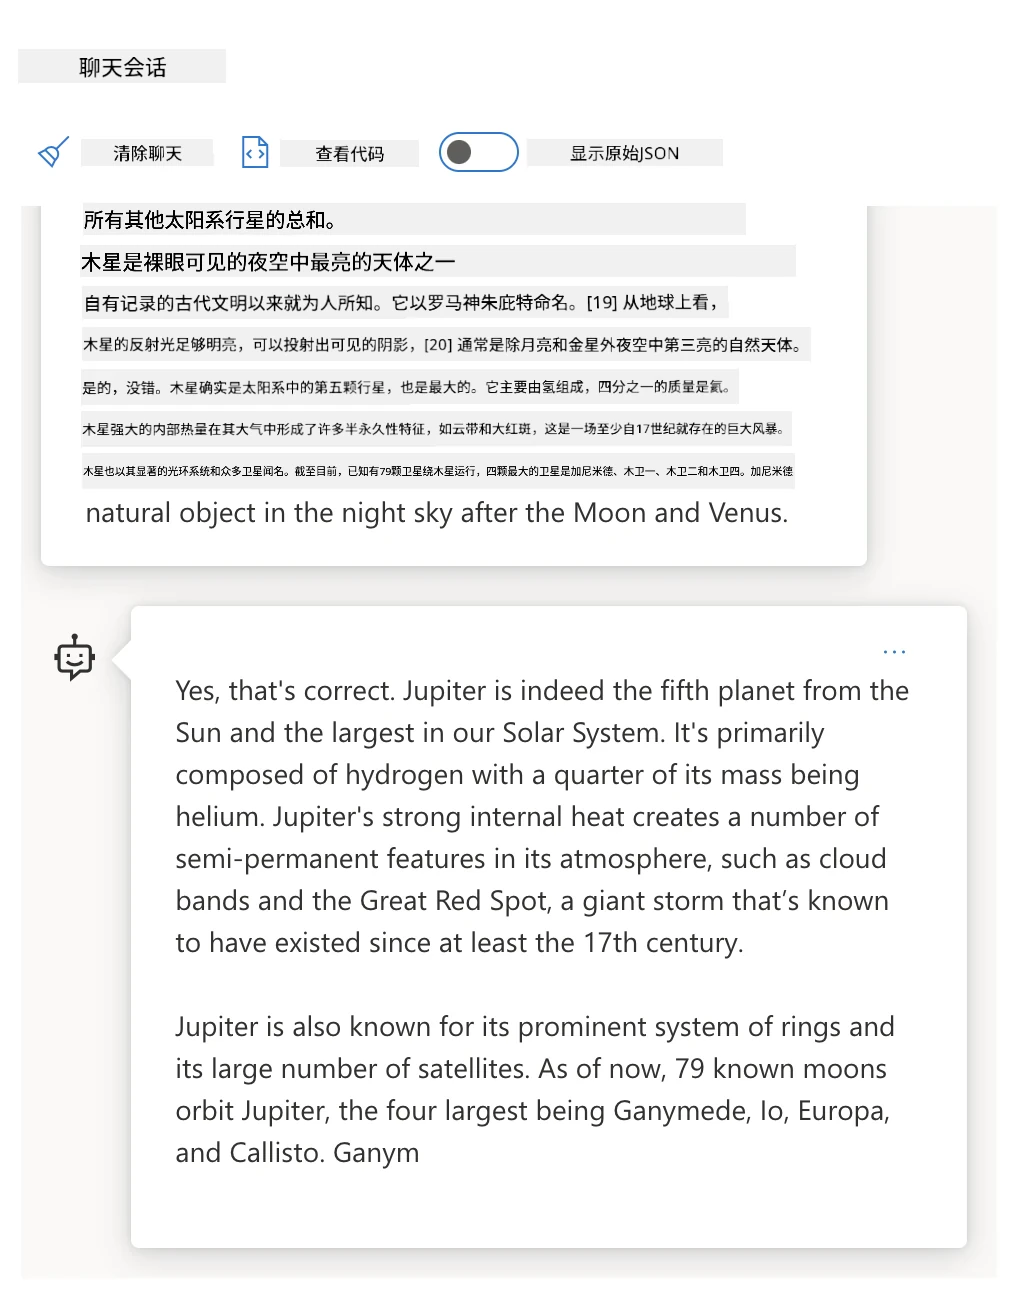
想看看基于提示词的补全是怎么工作的吗?把上面那段提示词输入 Microsoft Foundry 操练场(playground),使用默认设置。系统被配置为把提示词当作信息请求,所以你应该会看到一个符合这种情境的补全。
但如果用户想得到符合某些标准或任务目标的特定内容呢?这时就轮到指令调优的 LLM 登场了。
概念:指令调优的 LLM
指令调优的 LLM 以基础模型为起点,用示例或输入/输出对(例如多轮“消息”)对它进行微调。这些示例中包含明确的指令,以及 AI 尝试遵循指令给出的回答。
这会用到基于人类反馈的强化学习(RLHF)等技术,训练模型遵循指令并从反馈中学习,让它给出的回答更适合实际应用,也更贴合用户的目标。
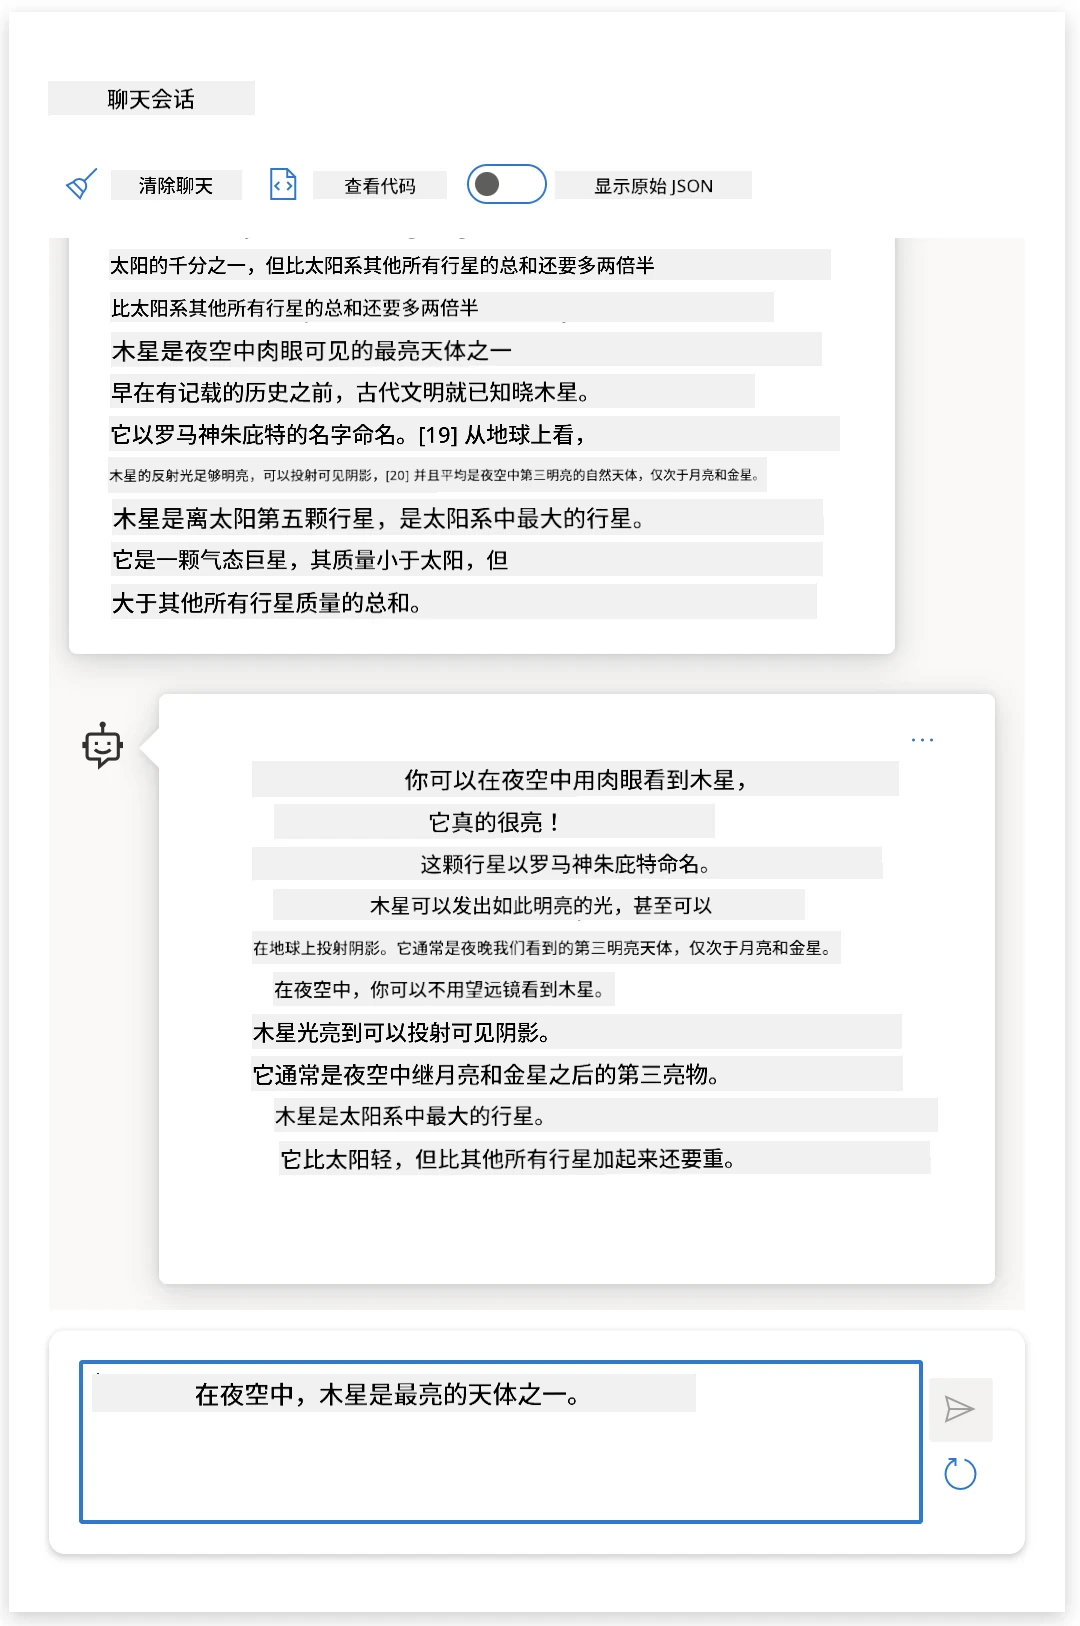
我们来试试:回到上面的提示词,但这次把系统消息改成下面这条指令,作为上下文:
为二年级学生总结你收到的内容。结果控制在一段话之内,包含 3 到 5 个要点。
看到结果是怎样按照期望的目标和格式调整的了吗?教师现在可以直接把这个回答放进那堂课的幻灯片里。
为什么需要提示词工程?
我们已经知道 LLM 怎样处理提示词,接下来谈谈为什么需要提示词工程。原因在于,当前的 LLM 存在一些问题,如果不在构造和优化提示词上下功夫,就很难得到可靠、一致的补全。例如:
-
模型的回答是随机的。 同一个提示词在不同的模型或模型版本上,很可能得到不同的回答;甚至在同一个模型上,不同时间也可能得到不同的结果。提示词工程技术可以提供更好的约束,帮助我们尽量减少这些差异。
-
模型可能会编造回答。 模型是在庞大但有限的数据集上预训练的,这意味着它们不了解训练范围之外的概念。因此,它们可能给出不准确、凭空想象,甚至与已知事实直接矛盾的补全。提示词工程技术可以帮助用户识别并减少这类编造,比如要求 AI 给出引用来源或推理过程。
-
模型的能力各不相同。 更新的模型或新一代模型能力更强,但也会带来各自的怪癖,以及成本和复杂度上的取舍。提示词工程可以帮助我们形成最佳实践和工作流程,屏蔽这些差异,并以可扩展、顺畅的方式适应各个模型的特定要求。
我们在 OpenAI 或 Azure OpenAI 的 Playground 中实际看看:
- 把同一个提示词用在不同的 LLM 部署上(例如 OpenAI、Azure OpenAI、Hugging Face),你看到差异了吗?
- 在同一个 LLM 部署上(例如 Azure OpenAI playground)反复使用同一个提示词,这些差异又有什么不同?
编造示例
在本课程中,我们用“编造”(fabrication)一词,指 LLM 由于训练上的局限或其他限制,有时会生成与事实不符的信息的现象。你在一些热门文章或研究论文中,可能也听过它被称为“幻觉”。不过,我们强烈建议使用“编造”这个说法,以免不经意间把机器产生的结果说成人类的特质,把这种行为拟人化。从用词角度看,这也符合负责任 AI 准则,避免使用在某些语境下可能被认为冒犯或不够包容的词语。
想了解编造是怎么发生的吗?可以想一个提示词,让 AI 为一个根本不存在的话题生成内容(确保训练数据里找不到)。比如,我试了这样一个提示词:
提示词: 生成一份关于 2076 年火星战争的教案。
网上搜索显示,确实有关于火星战争的虚构作品(例如电视剧或小说),但没有一部是关于 2076 年的。常识也告诉我们,2076 年还在未来,不可能对应一个真实发生过的事件。
那么,用不同的 LLM 服务运行这个提示词,会发生什么呢?
回答 1:OpenAI Playground(GPT-35)
图略:OpenAI Playground(GPT-35)对上述提示词的回答截图(来源:原课程配图,见原课程第 4 课)
回答 2:Azure OpenAI Playground(GPT-35)
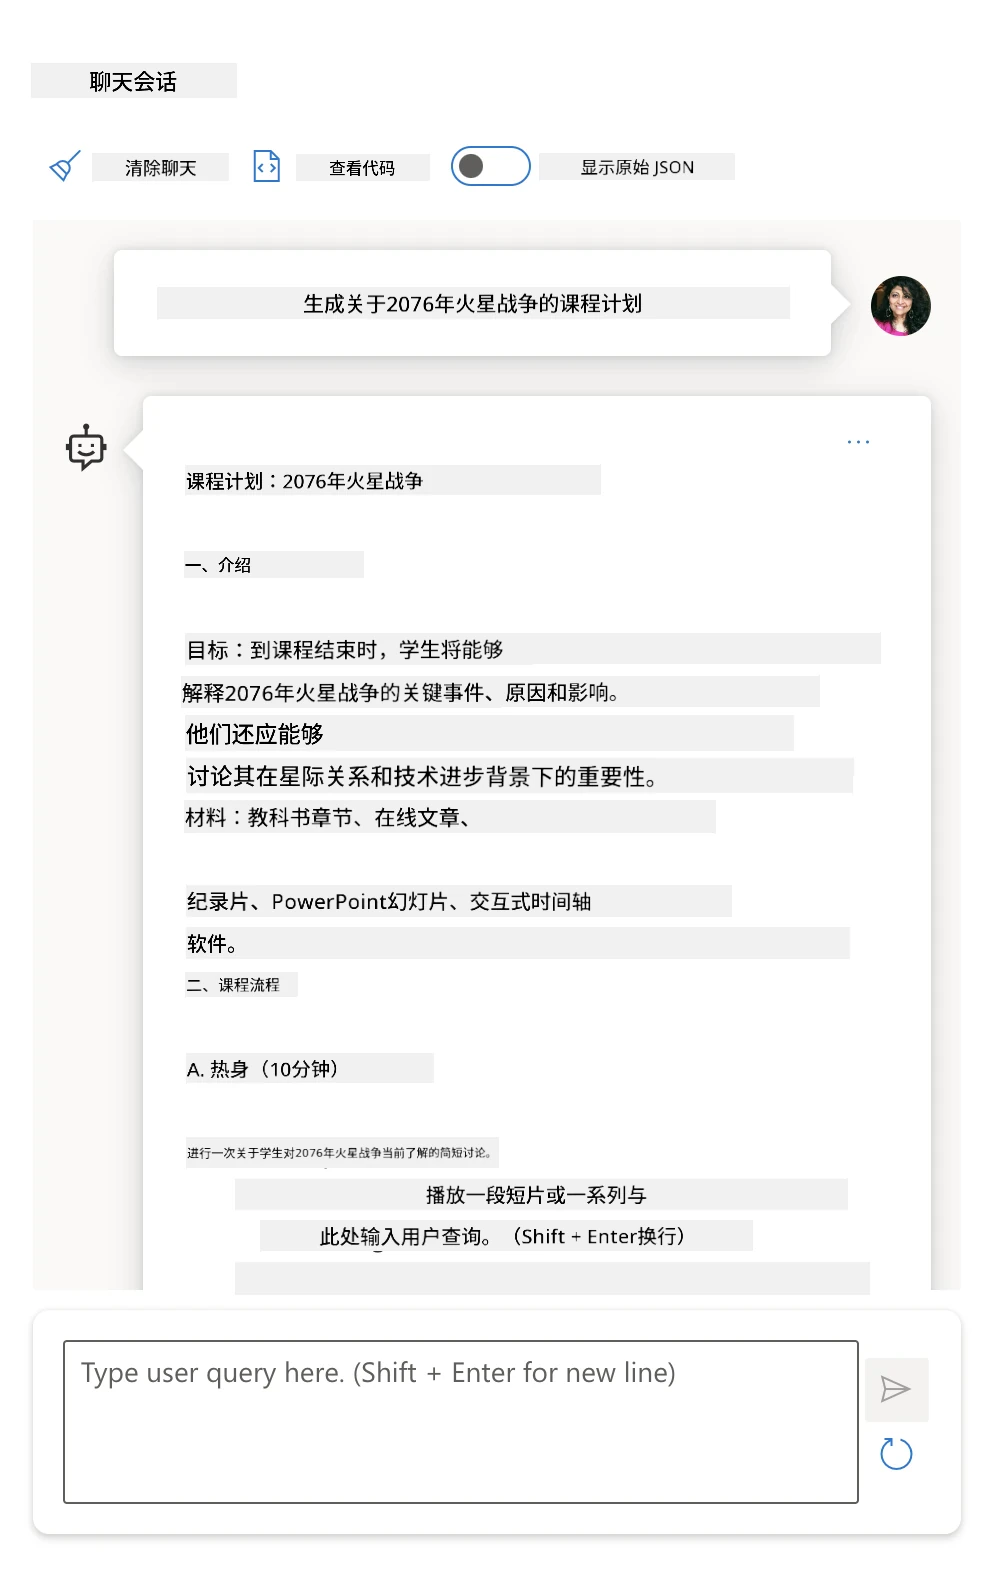
回答 3:Hugging Face Chat Playground(LLama-2)
图略:Hugging Face Chat Playground(LLama-2)对上述提示词的回答截图(来源:原课程配图,见原课程第 4 课)
正如预期,由于回答的随机性和模型能力的差异,每个模型(或模型版本)给出的回答都略有不同。例如,有一个模型面向的是八年级学生,另一个则假定对象是高中生。但三个模型生成的回答,都足以让不了解情况的用户相信这件事是真实的。
元提示词(metaprompting)和温度设置等提示词工程技术,也许能在一定程度上减少模型的编造。新的提示词工程架构还会把新的工具和技术无缝地融入提示词流程,以缓解或减少其中一些影响。
案例研究:GitHub Copilot
本节最后,我们通过一个案例研究,看看提示词工程在真实的解决方案中是怎样使用的:GitHub Copilot。
GitHub Copilot 是你的“AI 结对程序员”:它把文本提示词转换成代码补全,并集成在你的开发环境(例如 Visual Studio Code)中,使用体验很顺畅。正如下面这一系列博客所记录的,最早的版本基于 OpenAI Codex 模型,工程师们很快意识到,需要对模型进行微调,并开发更好的提示词工程技术,来提高代码质量。2023 年 7 月,他们推出了超越 Codex 的改进版 AI 模型,给出建议的速度更快。
按顺序阅读这些文章,跟随他们的学习历程。
- 2023 年 5 月 | GitHub Copilot 越来越懂你的代码
- 2023 年 5 月 | GitHub 内部:与 GitHub Copilot 背后的 LLM 打交道
- 2023 年 6 月 | 如何为 GitHub Copilot 写出更好的提示词
- 2023 年 7 月 | ……GitHub Copilot 用改进的 AI 模型超越 Codex
- 2023 年 7 月 | 写给开发者的提示词工程与 LLM 指南
- 2023 年 9 月 | 如何构建企业级 LLM 应用:来自 GitHub Copilot 的经验
以上文章均为英文。你还可以浏览他们的工程博客,阅读更多类似这一篇的文章,看看这些模型和技术是怎样应用到真实应用中的。
提示词的构成
我们已经了解了提示词工程为什么重要,现在来看看提示词是怎样构成的,这样才能评估不同的技术,设计出更有效的提示词。
基本提示词
先从基本提示词开始:发送给模型的一段文本输入,没有任何其他上下文。下面是一个例子:当我们把美国国歌的开头几个词发给 OpenAI 的 Completion API 时,它立刻用接下来的几句补全了回答,展示了最基本的预测行为。
| 提示词(输入) | 补全(输出) |
|---|---|
| Oh say can you see | 听起来你是在念美国国歌《星条旗》(The Star-Spangled Banner)的歌词开头。完整歌词是…… |
复杂提示词
现在,我们给这个基本提示词加上上下文和指令。Chat Completion API 让我们可以把复杂提示词构造成一组消息,其中包括:
- 输入/输出对,分别对应用户的输入和助手的回答。
- 系统消息,为助手的行为或个性设定情境。
现在请求的形式如下,分词会有效地捕捉上下文和对话中的相关信息。这时,修改系统上下文对补全质量的影响,可能和用户输入一样大。
response = client.responses.create(
    model="gpt-5-mini",
    input=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Who won the world series in 2020?"},
        {"role": "assistant", "content": "The Los Angeles Dodgers won the World Series in 2020."},
        {"role": "user", "content": "Where was it played?"}
    ]
)
编者注:这段示例代码中,系统消息设定“你是一个乐于助人的助手”;用户先问“2020 年世界大赛(美国职业棒球)谁赢了?”,助手答“洛杉矶道奇队赢得了 2020 年世界大赛”;用户接着问“比赛在哪里举行?”。
指令提示词
在上面的例子中,用户提示词只是一个简单的文本查询,可以理解为一个信息请求。用指令提示词,我们可以用文字更详细地说明任务,给 AI 更好的指引。示例如下:
| 提示词(输入) | 补全(输出) | 指令类型 |
|---|---|---|
| 写一段关于(美国)南北战争的介绍 | 返回一段简单的文字 | 简单 |
| 写一段关于(美国)南北战争的介绍。列出关键日期和事件,并说明它们的意义 | 返回一段文字,后面跟着一份带说明的关键事件日期清单 | 复杂 |
| 用一段话介绍(美国)南北战争。用 3 个要点列出关键日期及其意义,再用 3 个要点列出关键历史人物及其贡献。以 JSON 文件的形式返回结果 | 在文本框中返回更详尽的内容,格式为 JSON,可以复制粘贴到文件中,并按需校验 | 复杂,有格式要求 |
主要内容
在上面的例子中,提示词仍然相当开放,由 LLM 自己决定预训练数据集中的哪些部分是相关的。采用主要内容(primary content)这种设计模式时,输入文本分为两部分:
- 一条指令(要做的动作)
- 相关内容(影响这个动作)
下面的例子中,指令是“用两句话总结这段内容”。
-
提示词(输入):
木星是从太阳往外数的第五颗行星,也是太阳系中最大的行星。它是一颗气态巨行星,质量只有太阳的千分之一,却是太阳系其他所有行星质量总和的两倍半。木星是夜空中肉眼可见的最亮天体之一,早在有文字记载的历史之前,古代文明就已经知道它。它以罗马神话中的神朱庇特命名。[19] 从地球上看,木星有时亮到它反射的光足以投下可见的影子,[20] 它平均是夜空中仅次于月亮和金星的第三亮的天然天体。
用两句简短的话总结这段内容
-
补全(输出):
木星是从太阳往外数的第五颗行星,也是太阳系中最大的行星,以夜空中最亮的天体之一而著称。它以罗马神话中的神朱庇特命名,是一颗气态巨行星,质量是太阳系其他所有行星质量总和的两倍半。
主要内容这一部分可以用多种方式来让指令更有效:
- 示例:不直接用指令告诉模型该做什么,而是给它一些示例,让它自己推断出规律。
- 引导语(cue):在指令后面接一段引导语,为补全开个头,引导模型给出更相关的回答。
- 模板:可重复使用的提示词“配方”,其中带有占位符(变量),可以针对具体用例填入数据进行定制。
下面来看看实际效果。
使用示例
这种做法是用主要内容给模型“喂”一些示例,展示某条指令下期望的输出是什么样,让它推断出期望输出的规律。根据提供的示例数量,可以分为零样本提示、单样本提示、少样本提示等。
这时,提示词由三部分组成:
- 任务描述
- 几个期望输出的示例
- 一个新示例的开头(它成了隐含的任务描述)
下面三个例子中,前两个是把英文翻译成西班牙语。
零样本(zero-shot)
- 提示词(输入):"The Sun is Shining"。翻译成西班牙语
- 补全(输出):"El Sol está brillando".
单样本(one-shot)
-
提示词(输入):
"The Sun is Shining" => "El Sol está brillando".
"It's a Cold and Windy Day" =>
-
补全(输出):"Es un día frío y ventoso".
少样本(few-shot)
-
提示词(输入):
球员跑垒 => 棒球
球员发球直接得分(ace) => 网球
球员击出六分球 => 板球
球员完成一记扣篮 =>
-
补全(输出):篮球
注意,在零样本提示中,我们必须给出明确的指令(“翻译成西班牙语”),而在单样本的例子中,这条指令是模型自己推断出来的。少样本的例子则说明,增加示例后,模型无需额外的指令就能做出更准确的推断。
引导语
使用主要内容的另一种技术,是提供引导语而不是示例。也就是先用一小段体现期望回答格式的文字开个头,轻轻推模型往正确的方向走,模型随后会“接过话头”,按这个路子继续写下去。
0 条引导语
-
提示词(输入):
木星是从太阳往外数的第五颗行星,也是太阳系中最大的行星。它是一颗气态巨行星,质量只有太阳的千分之一,却是太阳系其他所有行星质量总和的两倍半。木星是夜空中肉眼可见的最亮天体之一,早在有文字记载的历史之前,古代文明就已经知道它。
总结一下
-
补全(输出):
木星是太阳系中最大的行星,也是从太阳往外数的第五颗行星。它是一颗气态巨行星,质量是太阳的千分之一,却比其他所有行星加起来还要重。古代文明很早就知道木星,它在夜空中很容易看到。
1 条引导语
-
提示词(输入):
(同上一段关于木星的文字)
总结一下
我们了解到,木星
-
补全(输出):
是从太阳往外数的第五颗行星,也是太阳系中最大的行星。它是一颗气态巨行星,质量是太阳的千分之一,却是其他所有行星质量总和的两倍半。它用肉眼就很容易看到,自古以来就为人所知。
2 条引导语
-
提示词(输入):
(同上一段关于木星的文字)
总结一下
我们了解到的三大事实:
-
补全(输出):
- 木星是从太阳往外数的第五颗行星,也是太阳系中最大的行星。
- 它是一颗气态巨行星,质量是太阳的千分之一……
- 自古以来,人们就能用肉眼看到木星……
提示词模板
提示词模板是一种预先定义好的提示词配方,可以保存下来、按需重复使用,从而大规模地提供更一致的用户体验。最简单的形式,就是一组提示词示例,比如 OpenAI 的这个示例,它既提供交互式的提示词组成部分(用户消息和系统消息),也提供通过 API 发送请求的格式,方便重复使用。
更复杂的形式,比如 LangChain 的这个示例,其中包含占位符,可以用各种来源的数据(用户输入、系统上下文、外部数据源等)替换,动态生成提示词。这样我们就能建立一个可复用的提示词库,以编程方式大规模地提供一致的用户体验。
最后,模板真正的价值在于,可以为垂直应用领域创建并发布提示词库:其中的提示词模板经过优化,体现特定应用的上下文或示例,让回答对目标用户更相关、更准确。Prompts For Edu 仓库就是这种做法的一个好例子,它为教育领域整理了一个提示词库,重点覆盖备课、课程设计、学生辅导等关键目标。
辅助内容
如果把提示词的构成看作一条指令(任务)加上一个对象(主要内容),那么辅助内容(secondary content)就是我们额外提供、用来以某种方式影响输出的上下文。它可以是调节参数、格式说明、主题分类等,帮助模型调整回答,以符合用户期望的目标或预期。
例如:假设有一份课程目录,其中包含课程体系里所有课程的丰富元数据(名称、简介、级别、元数据标签、授课教师等):
- 我们可以用一条指令要求“总结 2023 年秋季的课程目录”
- 用主要内容提供几个期望输出的示例
- 用辅助内容指定最受关注的 5 个“标签”
这样,模型就能按照那几个示例的格式给出总结;而如果某门课有多个标签,它会优先考虑辅助内容中指定的那 5 个标签。
提示词的最佳实践
既然已经知道提示词可以怎样构成,就可以开始思考怎样设计提示词,让它体现最佳实践。可以从两方面来考虑:具备正确的思维方式,以及运用合适的技术。
提示词工程的思维方式
提示词工程是一个试错的过程,所以要记住三条大的指导原则:
-
理解领域很重要。 回答的准确性和相关性,取决于应用或用户所在的领域。运用你的直觉和领域专业知识,进一步定制技术。例如,在系统提示词中定义带有领域特点的角色,或在用户提示词中使用针对该领域的模板。提供体现领域上下文的辅助内容,或者用领域特有的引导语和示例,引导模型走向熟悉的使用模式。
-
理解模型很重要。 我们知道模型本质上是随机的。但不同的模型实现,在使用的训练数据集(预训练知识)、提供的能力(例如通过 API 或 SDK)以及擅长的内容类型(例如代码、图像还是文本)等方面也可能不同。了解你所用模型的长处和局限,并据此安排任务的优先次序,或者构建针对模型能力优化的定制模板。
-
迭代和验证很重要。 模型在快速演进,提示词工程的技术也是如此。作为领域专家,你可能掌握你自己这个应用特有的上下文或标准,它们未必适用于更广泛的群体。先借助提示词工程的工具和技术“快速起步”构造提示词,再用你自己的直觉和领域专业知识反复迭代、验证结果。记录你的心得,建立一个知识库(例如提示词库),供其他人作为新的起点,让以后的迭代更快。
最佳实践
下面来看一些 OpenAI 和 Azure OpenAI 的实践者推荐的常见最佳实践。
| 做法 | 原因 |
|---|---|
| 评估最新的模型 | 新一代模型可能功能更强、质量更好,但成本也可能更高。先评估它们带来的影响,再决定是否迁移。 |
| 把指令和上下文分开 | 看看你的模型或服务商是否规定了分隔符,用来更清楚地区分指令、主要内容和辅助内容。这能帮助模型更准确地给各个 token 分配权重。 |
| 具体、清晰 | 对期望的上下文、结果、长度、格式、风格等给出更多细节,这能同时提高回答的质量和一致性。把好用的写法沉淀为可复用的模板。 |
| 描述充分,使用示例 | 模型可能对“边示范边讲解”的方式反应更好。先用零样本的方式(只给指令,不给示例)开始,再尝试用少样本的方式改进,给出几个期望输出的示例。也可以使用类比。 |
| 用引导语启动补全 | 给模型一些开头的词语或短语,作为回答的起点,推动它得出期望的结果。 |
| 加倍强调 | 有时你需要对模型把话重复一遍。可以在主要内容之前和之后都给出指令,或者同时使用指令和引导语,等等。通过迭代和验证,看看哪种做法有效。 |
| 顺序很重要 | 由于近因偏差,你向模型提供信息的顺序可能会影响输出,示例的顺序也是如此。尝试不同的顺序,看看哪种效果最好。 |
| 给模型留一条“退路” | 给模型一个兜底的回答,在它因为任何原因无法完成任务时使用。这能降低模型生成错误或编造回答的概率。 |
和所有最佳实践一样,请记住,效果因情况而异,取决于模型、任务和领域。把这些做法当作起点,不断迭代,找到最适合你的方式。随着新的模型和工具出现,要不断重新评估你的提示词工程流程,重点关注流程能否规模化以及回答的质量。
作业
恭喜你学完了本课!现在是时候用真实的示例,检验一下这些概念和技术了!
在作业中,我们会用一个 Jupyter Notebook,其中的练习可以交互式地完成。你也可以在 Notebook 里加入自己的 Markdown 单元和代码单元,自己探索各种想法和技术。
首先,fork 仓库,然后
- (推荐)启动 GitHub Codespaces
- (或者)把仓库克隆到本地设备,配合 Docker Desktop 使用
- (或者)用你喜欢的 Notebook 运行环境打开该 Notebook
接着,配置环境变量
- 把仓库根目录下的
.env.copy文件复制为.env,并填入AZURE_OPENAI_API_KEY、AZURE_OPENAI_ENDPOINT和AZURE_OPENAI_DEPLOYMENT的值。具体做法请回看学习沙盒一节。
然后,打开 Jupyter Notebook
- 选择运行内核。如果你用的是第 1 或第 2 种方式,直接选择开发容器提供的默认 Python 3.10.x 内核即可。
现在你可以开始做练习了。注意,这里的答案没有对错之分,只是通过试错来探索各种选项,培养对特定模型和应用领域什么做法有效的直觉。
因此,本课没有“代码解答”部分。Notebook 中会有标题为“我的解答:”的 Markdown 单元,给出一个示例输出供参考。
知识测试
下面哪一个提示词遵循了一些合理的最佳实践,是好的提示词?
- 给我看一张红色汽车的图片
- 给我看一张红色汽车的图片,品牌是沃尔沃,型号是 XC90,停在悬崖边,夕阳西下
- 给我看一张红色汽车的图片,品牌是沃尔沃,型号是 XC90
答案:2。它是最好的提示词,因为它提供了“是什么”的细节,而且说得很具体(不是随便一辆车,而是指定了品牌和型号),还描述了整体场景。3 次之,因为它也包含了不少描述。
🚀 挑战
试试能不能用“引导语”技术写这样一个提示词:补全句子“给我看一张红色汽车的图片,品牌是沃尔沃,并且”。模型会怎么回答?你会怎样改进它?
干得漂亮!继续学习
想进一步了解提示词工程的各种概念?可以去原课程推荐的延伸学习页面,找到这个主题的更多优质资源。
下一课(第 5 课)我们将学习高级提示词技术。
免责声明:本课中文原由 AI 翻译服务 Co-op Translator 机器翻译,本库已对照英文原文校订,并有删节。中英文如有出入,以英文原版为准。