
AI 学习资料 · 生成式 AI 入门(精选 7 课)
负责任地使用生成式人工智能
人们很容易被人工智能,尤其是生成式人工智能吸引,但你需要考虑如何负责任地使用它,比如如何确保输出公平、无害等等。本课将介绍相关背景、需要考虑的事项,以及如何主动采取措施,改进你对人工智能的使用。
介绍
本课将涵盖以下内容:
- 为什么在构建生成式人工智能应用时,应优先考虑负责任的人工智能。
- 负责任人工智能的核心原则,以及它们与生成式人工智能的关系。
- 如何通过策略和工具,把这些负责任人工智能的原则付诸实践。
学习目标
完成本课后,你将了解:
- 在构建生成式人工智能应用时,负责任人工智能为什么重要。
- 在构建生成式人工智能应用的过程中,什么时候应当思考并应用负责任人工智能的核心原则。
- 有哪些工具和策略,可以帮你把负责任人工智能的理念付诸实践。
负责任人工智能原则
人们对生成式人工智能的热情空前高涨,这股热潮为这一领域带来了大量新开发者、关注和资金。对任何想利用生成式人工智能打造产品、创办公司的人来说,这都是好事,但我们也必须负责任地前行。
在整个课程中,我们都围绕打造我们的初创企业和人工智能教育产品展开。我们将遵循负责任人工智能的原则:公平、包容、可靠与安全、安全与隐私、透明和问责。我们会借助这些原则,探讨它们与我们在产品中使用生成式人工智能有什么关系。
为什么要优先考虑负责任人工智能
打造产品时,坚持以人为本、时刻把用户的最大利益放在心上,才能取得最好的结果。
生成式人工智能的独特之处,在于它能为用户生成有用的答案、信息、指导和内容。这一切不需要太多手动步骤就能完成,效果往往令人惊叹。但如果缺乏妥善的规划和策略,它也可能给你的用户、你的产品乃至整个社会带来一些有害的后果。
下面来看其中一些(但并非全部)可能的有害后果:
幻觉
“幻觉”指的是大语言模型(LLM)生成的内容要么完全不知所云,要么根据其他信息来源可以确定是事实错误。
举个例子:我们为初创企业开发了一个功能,让学生可以向模型提历史问题。一名学生问:谁是泰坦尼克号的唯一幸存者?
模型给出了类似下面这样的回答:
图略:模型回答“谁是泰坦尼克号的唯一幸存者”这一提示词的截图(来源:Flying bisons)
这个回答非常笃定,也很详尽。可惜它是错的。只要稍加查证就会发现,泰坦尼克号灾难的幸存者不止一人。对一个刚开始研究这个话题的学生来说,这个答案可能足够有说服力,让人不加怀疑就当成事实。这样的结果会让人工智能系统变得不可靠,并损害我们初创企业的声誉。
每一代 LLM 在减少幻觉方面都有所进步。但即便如此,作为应用构建者和用户,我们仍要清楚这些局限。
有害内容
上一节讲了 LLM 给出错误或无意义回答的情况。我们还需要注意另一种风险:模型给出有害内容。
有害内容包括:
- 提供自残或伤害特定群体的方法,或鼓励这类行为。
- 仇恨或贬低他人的内容。
- 指导策划任何形式的攻击或暴力行为。
- 指导如何查找非法内容或实施违法行为。
- 展示露骨的色情内容。
我们的初创企业要确保有合适的工具和策略,防止学生看到这类内容。
缺乏公平性
公平性的定义是:“确保人工智能系统没有偏见和歧视,公平、平等地对待每个人。”在生成式人工智能领域,我们要确保模型的输出不会强化针对边缘群体的排斥性观念。
这类输出不仅会破坏我们为用户打造良好产品体验的努力,还会对社会造成进一步的伤害。作为应用构建者,我们在用生成式人工智能构建解决方案时,应始终把广泛而多样的用户群体放在心上。
如何负责任地使用生成式人工智能
我们已经明白了负责任地使用生成式人工智能的重要性,下面来看看负责任地构建人工智能解决方案可以采取的四个步骤:
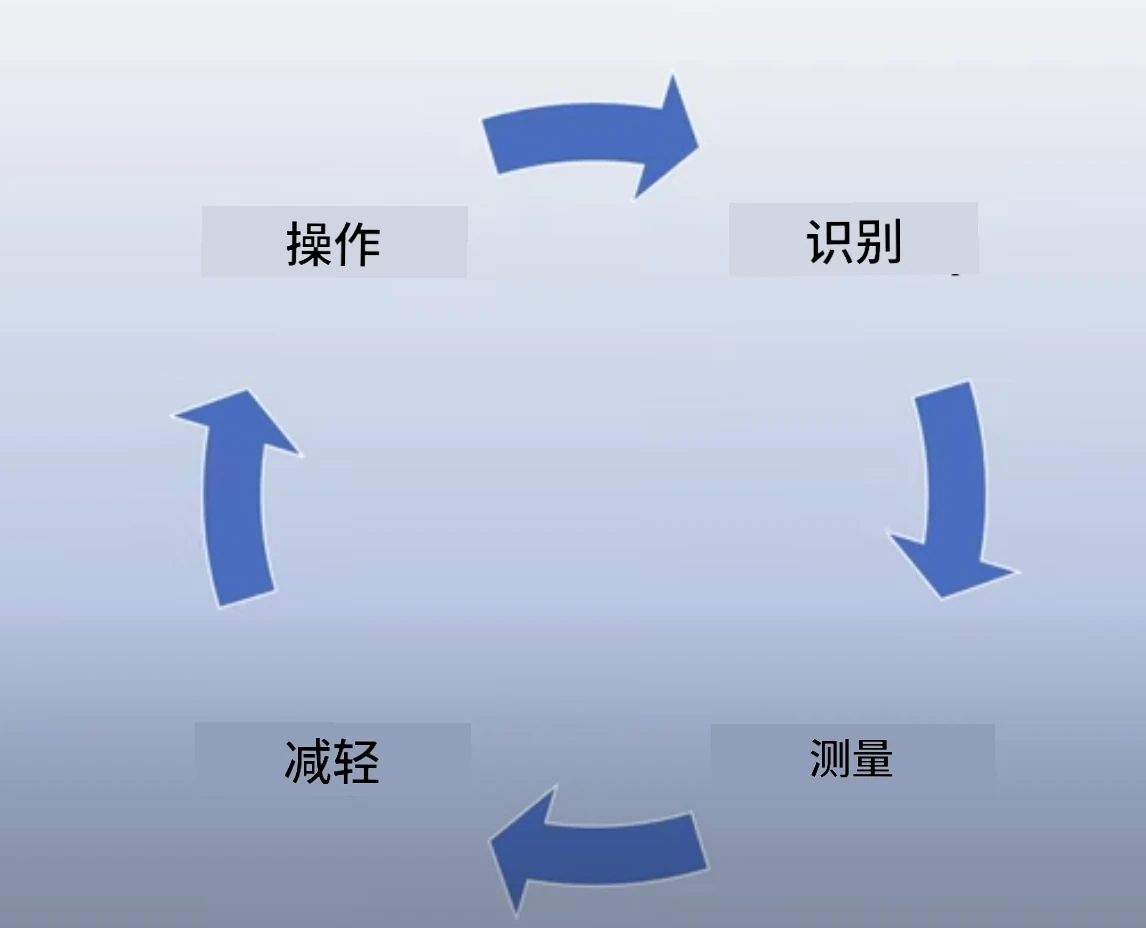
编者注:图中文字由机器翻译生成,其中“测量”“减轻”“操作”分别对应下文的“衡量”“缓解”“运营”。
衡量潜在危害
在软件测试中,我们会测试用户在应用上的预期操作。同样,拿用户最有可能使用的各种提示词来做测试,是衡量潜在危害的好方法。
我们的初创企业做的是教育产品,所以最好准备一份与教育相关的提示词清单,可以涵盖某个学科、历史事实,以及与学生生活有关的提示词。
缓解潜在危害
接下来要想办法防止或限制模型及其回答可能造成的危害。我们可以从四个不同的层面来看:
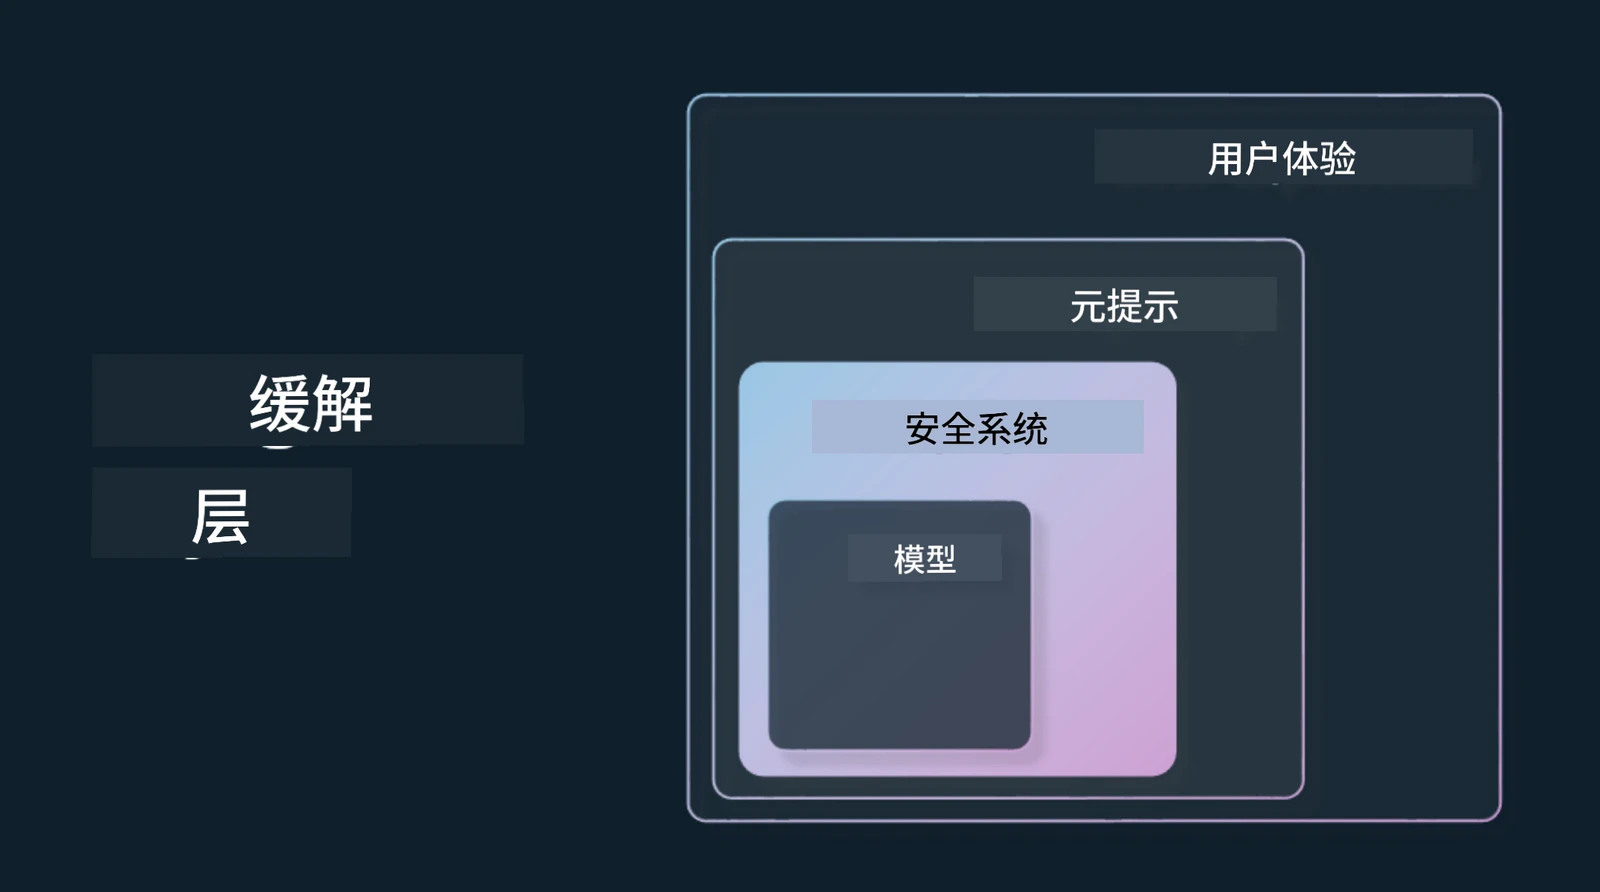
-
模型。为合适的场景选择合适的模型。把 GPT-4 这类更大、更复杂的模型用在范围较小、较具体的场景中,产生有害内容的风险可能更高。用你自己的训练数据进行微调,也能降低产生有害内容的风险。
-
安全系统。安全系统是运行模型的平台上用来帮助缓解危害的一组工具和配置,比如 Azure OpenAI 服务中的内容过滤系统。安全系统还应能检测越狱攻击和不希望出现的活动,比如来自机器人程序的请求。
-
元提示词。元提示词(metaprompt)和“接地”(grounding,即让回答以给定信息为依据)都是根据特定的行为和信息来引导或限制模型的方法。可以用系统输入为模型设定一些限制,还可以让输出更贴合系统的适用范围或领域。
也可以用检索增强生成(RAG)等技术,让模型只从一组可信来源中获取信息。本课程后面有一课专门讲构建搜索应用(原课程第 8 课,本库未收录)。
-
用户体验。最后一层是用户通过我们应用的界面与模型直接交互的地方。我们可以在 UI/UX 设计上限制用户能向模型发送哪些类型的输入,以及向用户展示哪些文本或图像。部署人工智能应用时,我们还必须坦诚说明我们的生成式人工智能应用能做什么、不能做什么。
原课程有一整课专门讲为 AI 应用设计用户体验(第 12 课,本库未收录)。
-
评估模型。使用 LLM 可能颇具挑战,因为我们并不总能掌控模型的训练数据。尽管如此,我们始终应该评估模型的表现和输出,衡量输出的准确性、相似度、有据性(groundedness)和相关性仍然很重要。这有助于向利益相关方和用户提供透明度,赢得信任。
运营负责任的生成式人工智能解决方案
最后一个阶段,是围绕你的人工智能应用建立一套运营实践。这包括与初创企业中法务、安全等其他部门合作,确保我们遵守所有监管政策。上线之前,我们还要制定交付、事件处理和回滚的计划,防止对用户造成的伤害扩大。
工具
开发负责任的人工智能解决方案,看起来工作量不小,但非常值得。随着生成式人工智能领域的发展,会有更多工具成熟起来,帮助开发者高效地把“负责任”融入工作流程。例如,Azure AI Content Safety(Azure AI 内容安全)可以通过 API 请求帮助检测有害内容和图像。
知识测试
为了确保负责任地使用人工智能,你需要关注哪些方面?
- 答案是否正确。
- 有害使用,即确保人工智能不会被用于犯罪目的。
- 确保人工智能没有偏见和歧视。
答案:2 和 3 正确。负责任的人工智能帮助你思考如何减轻有害影响和偏见等问题。
🚀 挑战
阅读 Azure AI Content Safety 的介绍,看看有哪些可以用在你自己的场景中。
出色的工作,继续学习
学完本课后,可以看看原课程推荐的生成式 AI 学习合集,继续提升你对生成式 AI 的了解。
下一课(第 4 课)我们将学习提示词工程基础。
免责声明:本课中文原由 AI 翻译服务 Co-op Translator 机器翻译,本库已对照英文原文校订,并有删节。中英文如有出入,以英文原版为准。