
AI 学习资料 · AI 智能体入门(精选 9 课)
第 12 课 AI 智能体的上下文工程
要做出可靠的 AI 智能体,先要弄清它所服务的那个应用有多复杂。我们需要构建能有效管理信息的 AI 智能体,去满足提示词工程之外的复杂需求。
本课介绍什么是上下文工程,以及它在构建 AI 智能体中的作用。
介绍
本课内容包括:
- 什么是上下文工程,它和提示词工程有什么不同。
- 有效进行上下文工程的策略,包括如何写入、挑选、压缩和隔离信息。
- 常见的上下文故障:哪些情况会让 AI 智能体偏离正轨,以及如何修复。
学习目标
学完本课,你将理解如何:
- 定义上下文工程,并把它和提示词工程区分开。
- 识别大语言模型(LLM)应用中上下文的关键组成部分。
- 运用写入、挑选、压缩和隔离上下文的策略,提升智能体的表现。
- 识别常见的上下文故障,例如中毒、分心、混淆和冲突,并采取缓解措施。
什么是上下文工程?
对 AI 智能体来说,上下文决定了它如何规划、采取哪些行动。上下文工程就是确保 AI 智能体拥有完成任务下一步所需的正确信息。上下文窗口的大小有限,所以作为智能体的构建者,我们需要建立系统和流程,管理上下文窗口里信息的添加、删除和精简。
提示词工程与上下文工程
提示词工程关注的是一套静态指令,用一组规则有效地引导 AI 智能体。上下文工程关注的是如何管理一组动态变化的信息(其中也包括最初的提示词),确保 AI 智能体在整个过程中都拥有所需的信息。上下文工程的核心,是让这个过程可重复、可靠。
上下文的类型
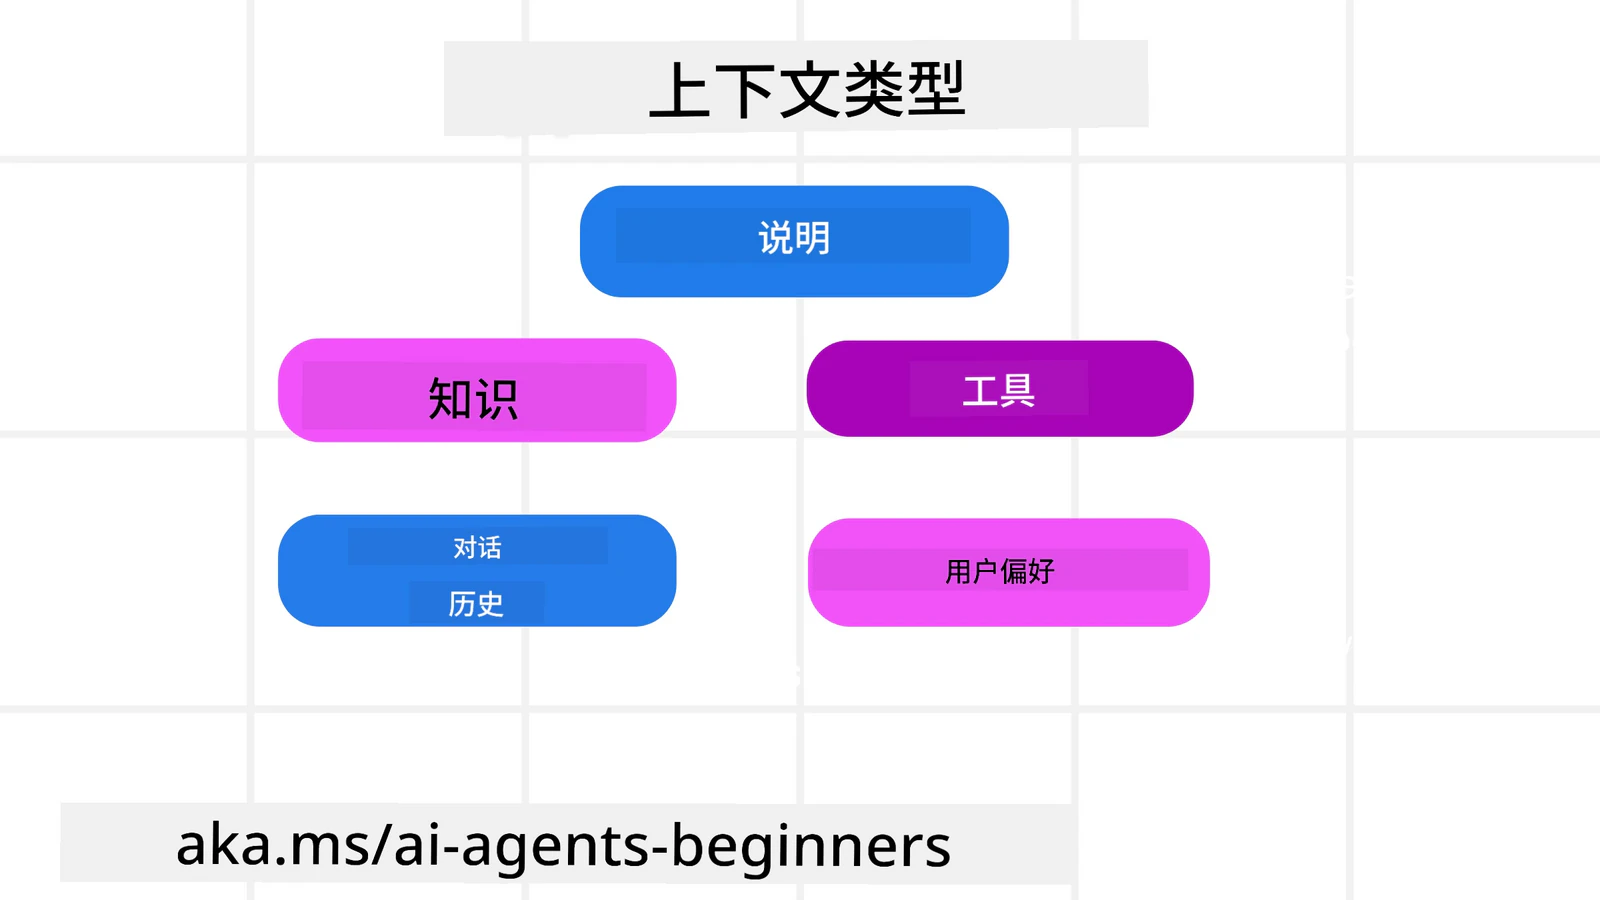
要记住,上下文不只是一样东西。AI 智能体需要的信息可能来自各种不同的来源,我们要确保智能体能访问这些来源。
AI 智能体可能需要管理的上下文类型包括:
- 指令:相当于智能体的“规则”,包括提示词、系统消息、少样本示例(向 AI 演示怎么做某件事),以及它可以使用的工具的描述。提示词工程和上下文工程在这里交汇。
- 知识:包括事实、从数据库检索到的信息,以及智能体积累的长期记忆。如果智能体需要访问不同的知识库和数据库,还包括接入检索增强生成(RAG)系统。
- 工具:智能体可以调用的外部函数、API 和 MCP 服务器的定义,以及调用它们后得到的反馈(结果)。
- 对话历史:与用户之间持续进行的对话。随着时间推移,对话会越来越长、越来越复杂,占用上下文窗口的空间。
- 用户偏好:随着时间推移了解到的用户喜好和厌恶。这些信息可以保存下来,在做关键决定时调出来,帮助用户。
有效进行上下文工程的策略
规划策略
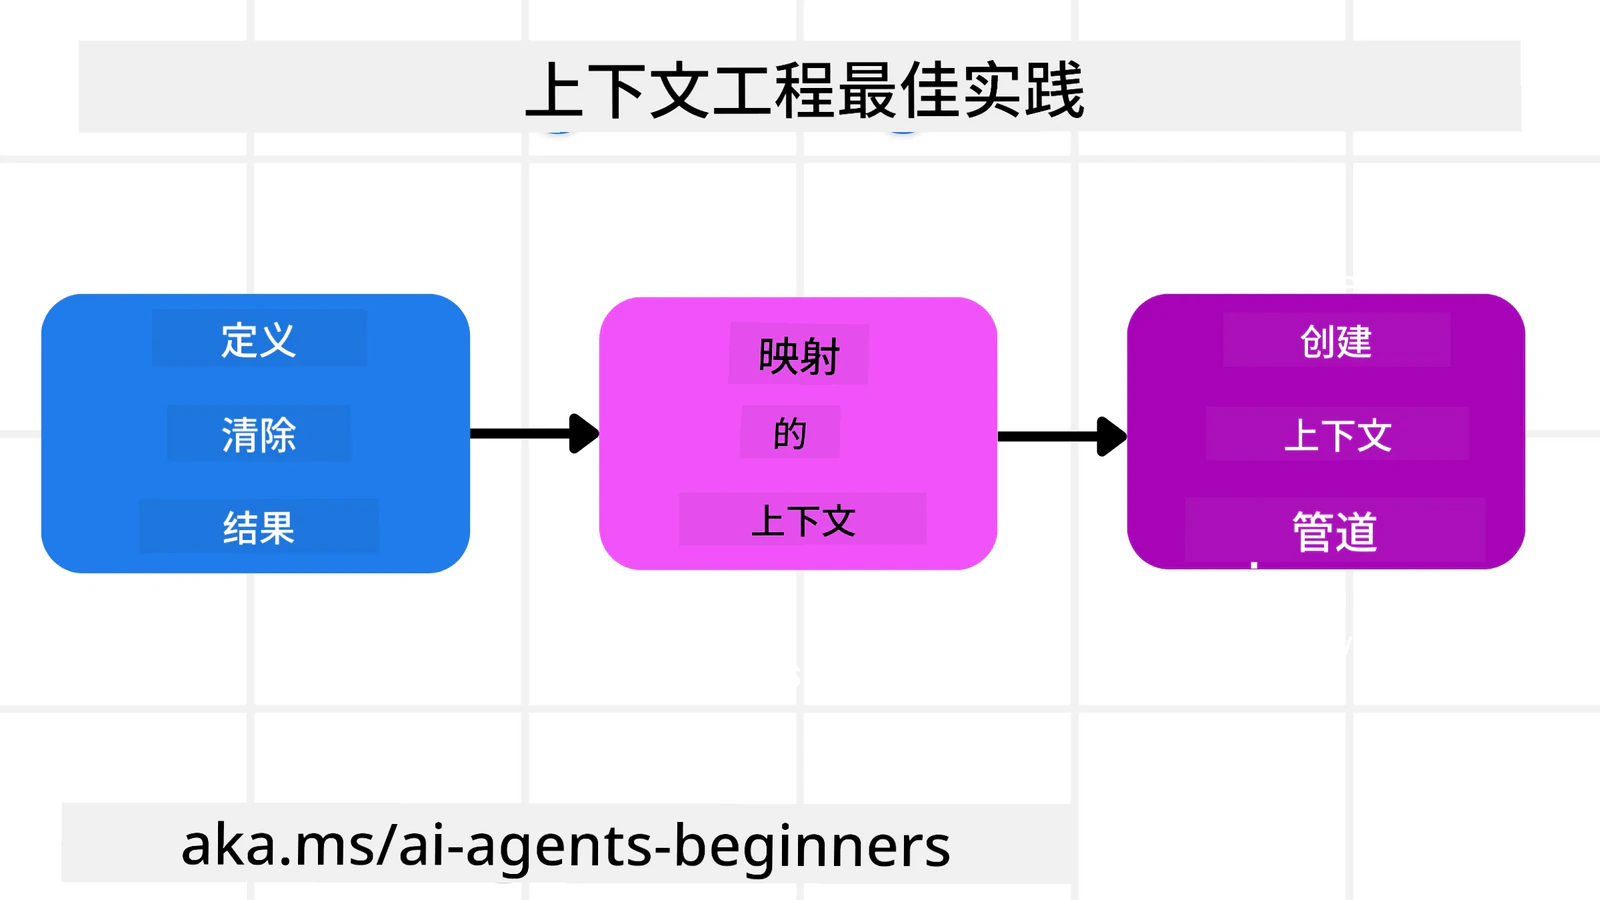
编者注:图中“定义清除结果”是机器翻译的误译,原意是“定义清晰的结果”;“映射的上下文”即“梳理上下文”。
好的上下文工程从好的规划开始。下面这个方法,可以帮你开始思考如何运用上下文工程:
- 定义清晰的结果:AI 智能体要完成的任务,其结果应当定义清楚。回答这个问题:“AI 智能体完成任务后,世界会是什么样子?”换句话说,用户与 AI 智能体交互之后,应该得到什么改变、信息或回应。
- 梳理上下文:定义好 AI 智能体的结果之后,要回答:“AI 智能体需要哪些信息才能完成这项任务?”这样就可以开始梳理这些信息分别在哪里。
- 建立上下文管道:知道信息在哪里之后,要回答:“智能体怎样拿到这些信息?”方式有很多种,包括 RAG、使用 MCP 服务器和其他工具。
实用策略
规划很重要,但信息一旦开始流入智能体的上下文窗口,我们就需要实用的策略来管理它:
管理上下文
有些信息会被自动加进上下文窗口,而上下文工程讲的是更主动地管理这些信息,可以用以下几种策略:
-
智能体便签(Agent Scratchpad):让 AI 智能体在单次会话中,把与当前任务和用户交互有关的信息记下来。便签应当放在上下文窗口之外,比如一个文件或运行时对象里,智能体在本次会话中需要时可以再取回。
-
记忆(Memories):便签适合管理单次会话中、上下文窗口之外的信息;记忆则让智能体能跨多次会话保存和取回相关信息,可以包括摘要、用户偏好,以及供日后改进的反馈。
-
压缩上下文:当上下文窗口越来越大、接近上限时,可以用摘要和裁剪等技术,比如只保留最相关的信息,或删掉较早的消息。
-
多智能体系统:开发多智能体系统本身也是一种上下文工程,因为每个智能体都有自己的上下文窗口。构建这类系统时,上下文如何在不同智能体之间共享和传递,也需要提前规划。
-
沙箱环境:如果智能体需要运行代码,或处理文档里的大量信息,处理结果可能会占用大量 token。与其把这些都放进上下文窗口,智能体可以使用一个能运行这些代码的沙箱环境,只读回结果和其他相关信息。
-
运行时状态对象:做法是建立一些信息容器,用来应对智能体需要访问特定信息的情况。对于复杂任务,智能体可以把每个子任务的结果逐步存起来,让上下文只与当前这个子任务相关。
检查上下文
用了上面某种策略之后,值得检查一下下一次调用模型时,模型实际收到了什么。一个有用的调试问题是:
智能体是加载了太多上下文、加载错了上下文,还是漏掉了需要的上下文?
回答这个问题,不需要记录原始的提示词、工具输出或记忆内容。在生产环境中,更适合留下体积很小的上下文检查记录,只记数量、ID、哈希值和策略标签:
- 挑选:记录考虑过多少候选片段、工具或记忆,选中了多少,以及是哪条规则或哪个分数把其余的过滤掉了。
- 压缩:记录来源范围或追踪 ID、摘要 ID、压缩前后的估计 token 数,以及原始内容是否已从下一次调用中排除。
- 隔离:记下哪个子任务是在单独的智能体、会话或沙箱中运行的,返回了怎样一份限定范围的摘要,以及大块的工具输出是否留在了父智能体的上下文之外。
- 记忆与 RAG:保存检索到的文档 ID、记忆 ID、分数、选中的 ID 和脱敏状态,而不是完整的检索文本。
- 安全与隐私:优先记录哈希值、ID、按区间粗分的 token 数和策略标签,而不是敏感的提示词原文、工具参数、工具结果或用户记忆的正文。
目的不是保留更多上下文,而是留下足够的证据,让开发者能判断用了哪种上下文策略,以及它是否按预期改变了下一次模型调用。
上下文工程示例
假设我们想让 AI 智能体“帮我订一趟去巴黎的行程”。
- 只用提示词工程的简单智能体,可能只会回答:“好的,你想什么时候去巴黎?”它只处理了你当时直接提出的问题。
- 采用本课所讲上下文工程策略的智能体会做得多得多。在回答之前,它的系统可能会:
- 查看你的日历,找出有空的日期(获取实时数据)。
- 回想你过去的出行偏好(来自长期记忆),比如你常坐的航空公司、预算,或者是否偏好直飞。
- 确认有哪些可用工具,比如机票和酒店预订工具。
然后,它的回答可能是:“嗨,[你的名字]!我看到你十月第一周有空。要我按你平时[预算]以内的标准,找[常坐的航空公司]直飞巴黎的航班吗?”这种更充实、能感知上下文的回答,正体现了上下文工程的威力。
常见的上下文故障
上下文中毒
是什么:幻觉(LLM 生成的虚假信息)或错误进入了上下文,并被反复引用,导致智能体去追求不可能实现的目标,或形成荒唐的策略。
怎么办:实施上下文校验和隔离。信息存入长期记忆之前先校验。一旦发现可能中毒,就开启新的上下文线程,防止错误信息扩散。
旅行预订示例:智能体凭空编造了一个从小型本地机场直飞某个遥远国际城市的航班,而这个机场其实根本没有国际航班。这条不存在的航班信息被存进了上下文。之后你让智能体预订时,它一直试图为这条不可能的航线找机票,导致反复出错。
解决方案:在把航班信息加入智能体的工作上下文之前,增加一个步骤,用实时 API 核实航班和航线是否真的存在。核实不通过,错误信息就被“隔离”,不再使用。
上下文分心
是什么:上下文变得太大,模型过于关注积累下来的历史,而没有运用它在训练中学到的东西,导致重复或无用的行动。甚至在上下文窗口还没满时,模型就可能开始出错。
怎么办:使用上下文摘要。定期把积累的信息压缩成较短的摘要,保留重要细节,去掉冗余的历史。这有助于“重置”模型的注意力。
旅行预订示例:你和智能体聊了很久各种梦想中的旅行目的地,还详细回顾了两年前的一次背包旅行。等你终于提出“帮我找下个月的便宜机票”时,智能体却被那些陈旧、无关的细节缠住,不停地问你背包装备或过去的行程,忽略了你当前的需求。
解决方案:对话达到一定轮数或上下文过大时,智能体应当把最近、最相关的对话内容总结一下,聚焦你当前的出行日期和目的地,用这份精简的摘要作为下一次调用 LLM 的上下文,舍弃不太相关的历史对话。
上下文混淆
是什么:不必要的上下文(常见的是可用工具太多)导致模型给出糟糕的回答,或调用不相关的工具。较小的模型尤其容易出现这种情况。
怎么办:用 RAG 技术进行工具装载管理。把工具描述存进向量数据库,针对每个具体任务只挑出最相关的工具。研究表明,可选工具最好控制在 30 个以内。
编者注:英文原文这句话没有写完(只写到“把可选工具限制在 30 个以内”),这里按上下文补全为“最好控制在 30 个以内”。
旅行预订示例:智能体可以使用几十个工具:book_flight、book_hotel、rent_car、find_tours、currency_converter、weather_forecast、restaurant_reservations 等。你问:“在巴黎怎么出行最方便?”因为工具实在太多,智能体被搞糊涂了,可能会在巴黎市内调用 book_flight,或者明明你更喜欢公共交通,它却调用了 rent_car。原因可能是工具描述有重叠,或者它就是分辨不出哪个工具最合适。
解决方案:对工具描述做 RAG 检索。你问巴黎怎么出行时,系统根据你的问题,动态检索出最相关的几个工具,比如 rent_car 或 public_transport_info,把这份精简过的工具清单交给 LLM。
上下文冲突
是什么:上下文中存在相互矛盾的信息,导致推理前后不一致,或最终回答出错。这常发生在信息分阶段到来、早先错误的假设仍留在上下文里的情况下。
怎么办:使用上下文剪枝和外置处理。剪枝是指在新信息到来时,删掉过时或相互冲突的信息。外置处理是给模型一个单独的“便签”工作区,在那里处理信息,不把主上下文弄乱。
旅行预订示例:你一开始告诉智能体:“我想坐经济舱。”后来聊着聊着你改了主意:“其实这次我们坐商务舱吧。”如果两条指令都留在上下文里,智能体可能会拿到相互矛盾的搜索结果,或者不确定该优先按哪个偏好来。
解决方案:实施上下文剪枝。当新指令与旧指令冲突时,把旧指令从上下文中删掉,或明确地覆盖掉。另一种办法是,智能体先用便签把相互冲突的偏好理清楚再做决定,确保只有最终、一致的指令来指导它的行动。
免责声明:本课中文最初由 AI 翻译工具 Co-op Translator 自动翻译,本库对照英文原文做了校订和删节。译文仍可能有错漏,与英文原版不一致之处,以英文原版为准。